Jevとは|3つの型付き判断でClaude Code・Codexを補完
代表取締役 上坂大地郎
結論: Jevは、Claude CodeやCodexのように文章やコードを生成するAIエージェントではありません。アプリやエージェントの途中で発生する「どの処理へ進むか」「どの程度リスクがあるか」「条件を満たすか」という小さな判断を、Choice・Score・Noulの3種類の型付きデータとして返すモデルです。Claude CodeやCodexを置き換えるのではなく、判断部分を分担させることで、処理を速く、安く、コードから扱いやすくする補完関係にあります。
この記事の要点:
- TypeSafe AIは2026年9月15日、最初のSystem OneモデルとしてJevを発表しました。現行の安定版は
jev-1.13.0で、公式価格は入力100万トークンあたり0.042ドル、出力は無料です(TypeSafe AI公式、参照日: 2026-09-24) - Jevが返すのは自由文ではなく、選択肢と確率、段階評価、真偽の確率です。文章・コード生成、ツール実行、ファイル編集は行いません
- Claude CodeやCodexにJevを組み込むと、ツール選択、モデル振り分け、RAGの候補選別、品質判定、実行前ガードなどを、生成モデルとは別の「判断レイヤー」として設計できます
対象読者: Claude CodeやCodexを使っているエンジニア、AIエージェントやLLMアプリを設計している方、生成AIのAPI費用と待ち時間を減らしたい開発チーム
読了後にできること: Jevが向く処理と向かない処理を切り分け、3つのプリミティブから適切な出力型を選び、Claude CodeまたはCodexに実装を依頼できる状態になります。
Jevは「新しいコーディングエージェント」として見ると、理解を誤ります。比べるべき対象というより、生成モデルが担ってきた判断の一部を切り出す部品です。この記事では公式ドキュメントと公開時点の仕様をもとに、何が新しく、何に便利で、Claude CodeやCodexとどう組み合わせるのかを整理します。
Claude Codeの長いセッションでコストを抑える方法は「Claude Codeトークン節約術」で扱っています。エージェントごとの特徴を知りたい場合は「Cursor vs Claude Code」も参照してください。
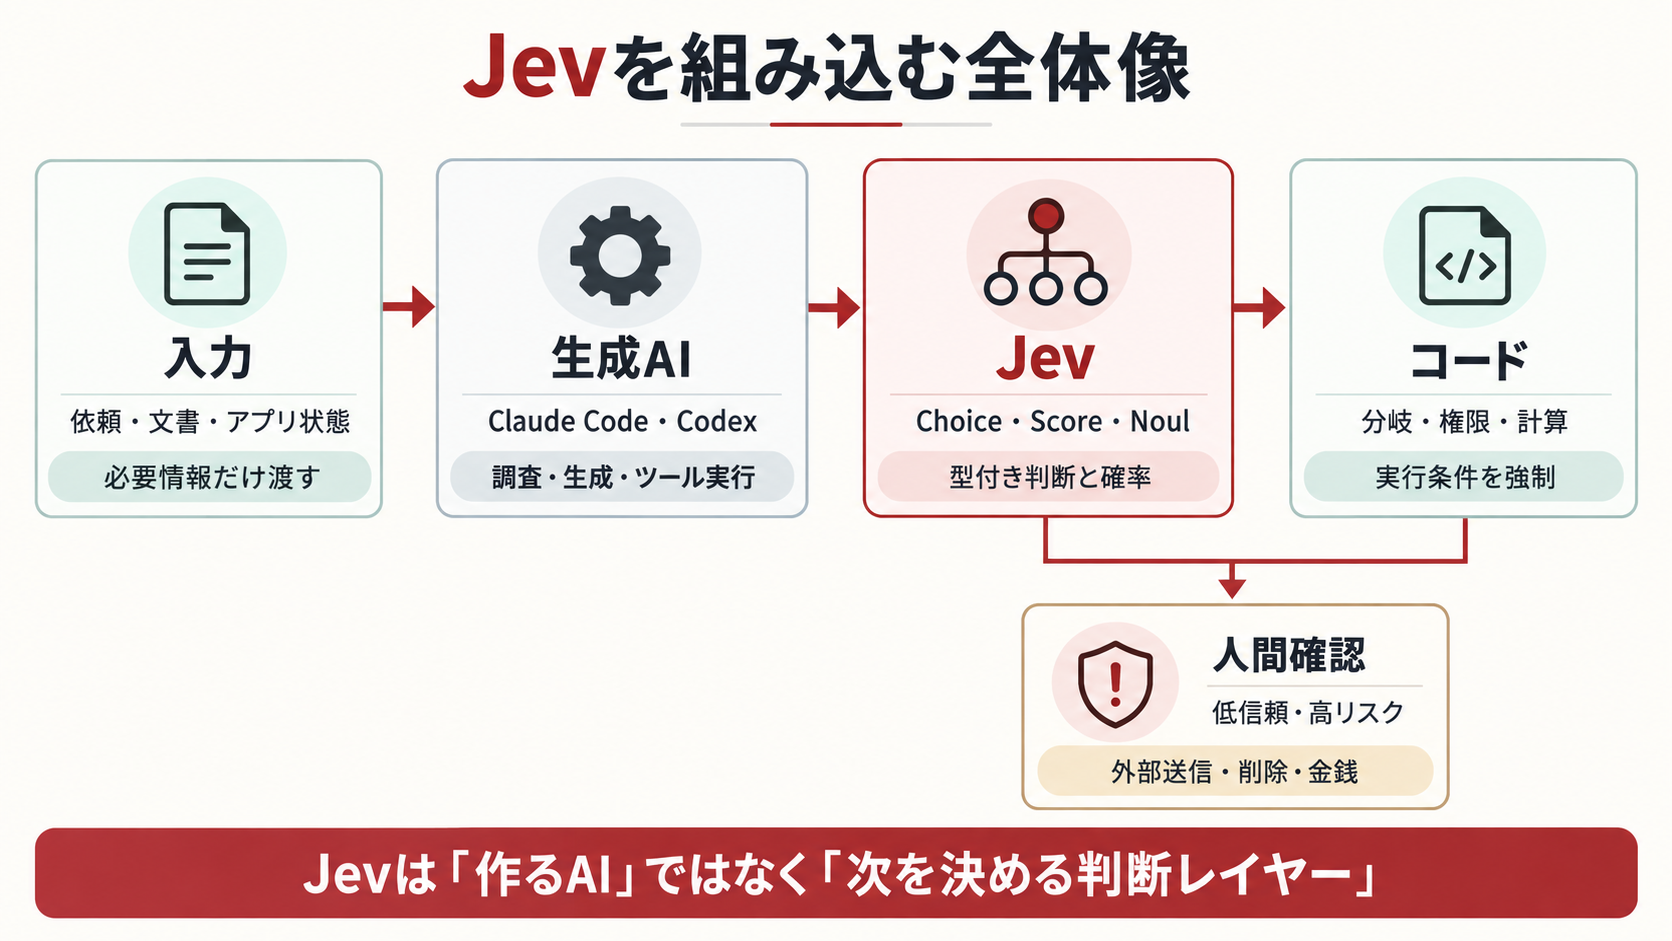
Jevは生成AIの代わりではなく、アプリやエージェントの途中に置く判断レイヤーです。高リスクや低信頼のケースはコードで人間確認へ戻します。
Jevの正体 — 「文章ではなく判断」を返すAI
TypeSafe AIはJevを、同社初のSystem Oneモデルと説明しています。一般的な大規模言語モデルが、人に読ませる文章を一語ずつ生成するのに対し、Jevは入力された状態(state)に対する質問へ、ソフトウェアがそのまま利用できる構造化データで回答します。
System Oneは「速い直感」をソフトウェア向けにした呼び名
名称は、ダニエル・カーネマンが広めた「速く直感的なSystem 1」と「遅く熟考するSystem 2」の対比に由来します。Jevに向くのは、長い推論や文章作成ではなく、十分な情報を渡せば数秒以内に判定できる、範囲の狭い意味判断です。
たとえるなら、Claude CodeやCodexは、状況を調べて計画し、手を動かして成果物を作る担当者です。Jevは受付や分岐器に近く、届いた案件を分類し、優先度を付け、危険なら止めます。受付だけでは仕事は完了しませんが、すべての案件を熟練者が最初から読む必要はなくなります。
入力は状態と質問、出力は型と確率
JevのAPIには、評価対象となるテキストまたはJSONをstateとして渡し、同じ状態に対する質問をquestionsへ並べます。返答は質問IDごとのanswersです。自由文をJSONらしく書かせて後から解析するのではなく、最初から決めた型で値が返ります。
この違いは小さく見えますが、アプリから扱うと大きな差になります。生成モデルでは「JSONだけ返して」と指示しても、説明文や想定外のキーが混ざる可能性があります。Jevは回答の候補と形を先に定義するため、存在しない部署名やツール名を文字列として作りません。
ただし、ここで保証されるのは出力形式です。選ばれた候補が意味的に正しいとは限りません。公式ドキュメントも、Jevは誤る可能性があり、用途ごとの検証と信頼度に応じた分岐が必要だと説明しています。
3つのプリミティブ — Choice・Score・Noul
Jevで使える質問型は3種類です。複雑な判断を1問へ詰め込むのではなく、狭い問いへ分解し、最後の組み合わせはコードに持たせるのが基本です。
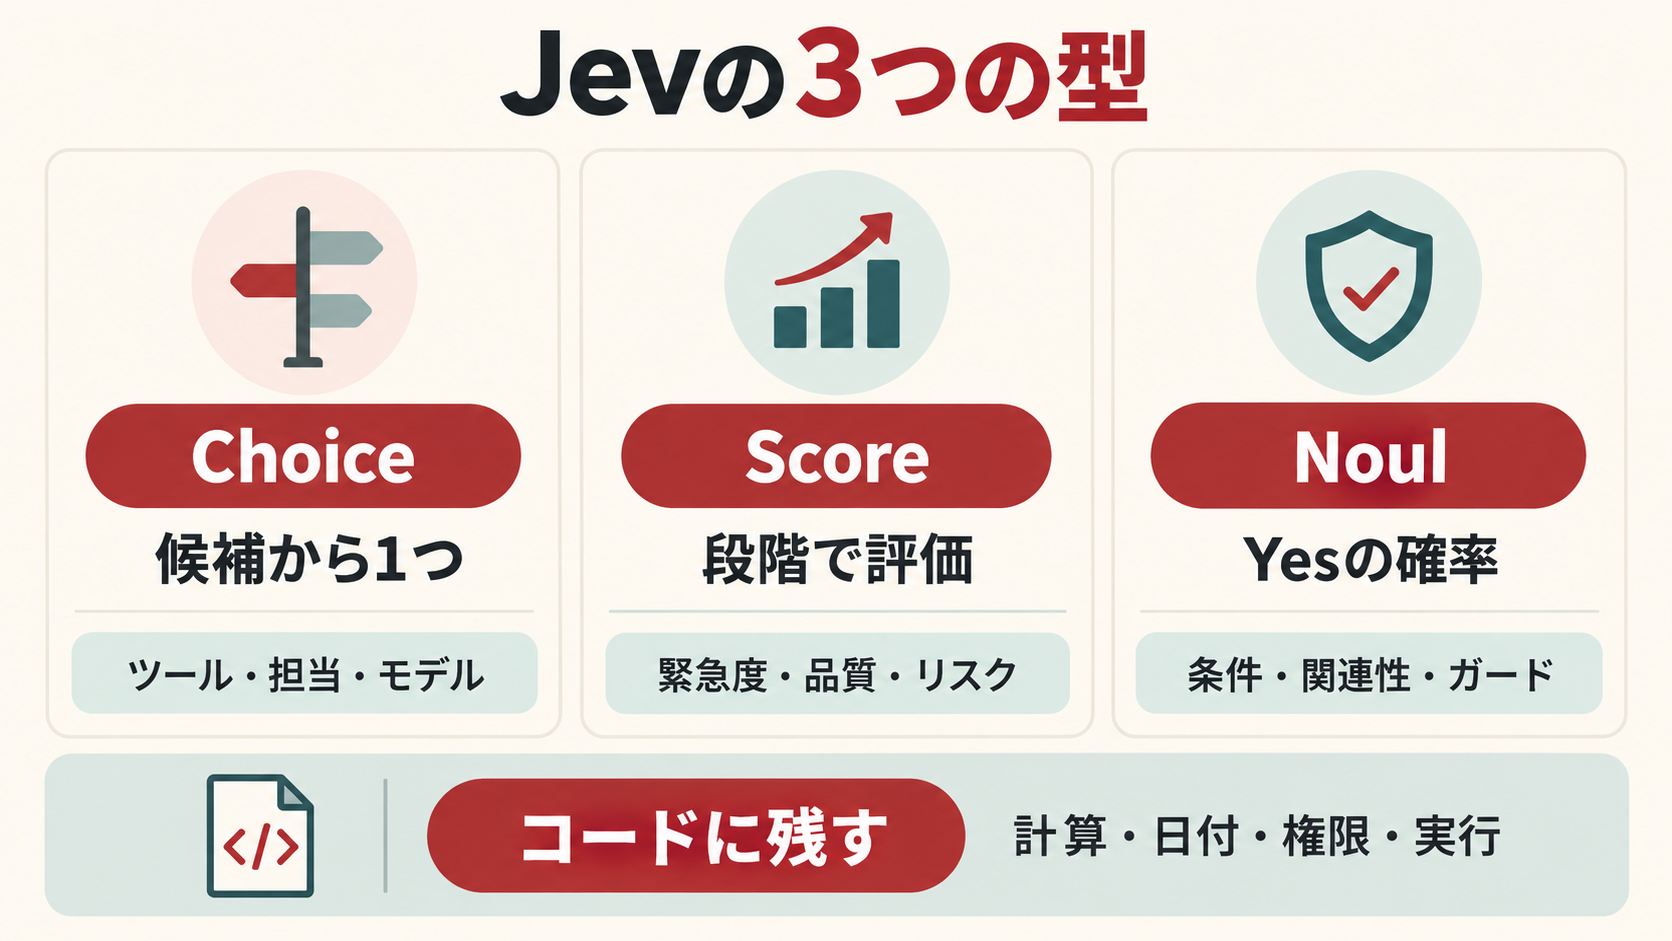
選択、段階評価、真偽確率を使い分けます。計算や最終的な実行条件はJevへ任せず、通常のコードに残します。
Choice — 決めた候補から1つ選ぶ
Choiceは、あらかじめ定義した候補から1つを選びます。たとえば問い合わせをbilling、technical、salesへ振り分ける、エージェントが次に使うツールを候補一覧から選ぶ、といった用途です。
返答には選択結果だけでなく、全候補の確率分布とconfidenceが含まれます。1位と2位が拮抗していれば、自動実行せず確認へ回す判断ができます。候補外の値を生成しないことと、候補内で正解することは別なので、選択肢の設計とフォールバックが重要です。
Score — 定義した段階で評価する
Scoreは、内容を順序付きの基準で評価します。「落ち着いている」「不満がある」「強い怒りがある」の3段階や、コード変更のリスクを低・中・高で判定する場面に使えます。
Scoreは厳密な数値計算の代わりではありません。公式の制約ページは、Jev 1.13が数の精密さや計数を苦手とし、計算をコード側へ置くよう求めています。売上金額の合計や日付の前後関係をScoreで推測させる設計は避けます。
Noul — 「この条件に当てはまるか」の確率を返す
Noulは、真偽で表せる1つの命題について、真である確率を0〜1で返します。「この依頼は返金を求めているか」「この検索結果は質問への回答を含むか」「この変更は認証処理に触れているか」といった確認に向きます。
ChoiceとScoreが持つconfidenceとは違い、Noulが返す値自体が「Yesの確率」です。0.7を自動実行の境界にするか、人間確認へ回すかは、誤判定したときの損失に合わせてコードで決めます。
型 | 返すもの | 向いている処理 | 向かない処理 |
|---|---|---|---|
Choice | 候補1つ、候補別確率、信頼度 | ツール選択、担当振り分け、モデル選択 | 候補にない文章やコードの生成 |
Score | 段階評価、段階別確率、信頼度 | 緊急度、品質、リスクの段階評価 | 正確な計算、件数の集計 |
Noul | 真である確率0〜1 | 条件判定、関連性、ガード | 複数候補の相対比較、理由文の生成 |
Claude Code・Codexとは役割が違う
Jev、Claude Code、Codexはいずれも開発の文脈で話題になりますが、製品の階層が異なります。Jevは判断モデル、Claude CodeとCodexは生成モデルを使って調査・編集・実行まで進めるエージェントです。
Claude CodeとCodexは「作業を完了する」
AnthropicはClaude Codeを、コードベースを調べ、ファイルを編集し、コマンドやテストを実行できるエージェント型コーディングツールとして提供しています。OpenAIのCodexも、機能開発、リファクタリング、移行、レビューなどを終端まで進めるコーディングエージェントです。
両者は自然言語で依頼を受け、途中で必要な情報を探し、複数の手順を組み立て、文章やコードを生成します。作業によっては人へ質問し、ツールを使い、失敗すれば別の手順を試します。この柔軟さが、コーディングエージェントの強みです。
Jevは「途中の分岐を決める」
Jevは会話を続けず、ファイルも編集せず、ツールも実行しません。TypeSafe AIの公式ドキュメントには、model: "jev-latest"を指定してClaude CodeやCodexの本体モデルをJevへ交換する使い方はできない、と明記されています。
代わりに、エージェントの内部や周辺で何度も起きる小さな判断を担当させます。たとえば、変更要求を「軽微な修正」「設計レビューが必要」「セキュリティ確認が必要」に分け、結果に応じてCodexのプロファイルや人間レビューへ振り分ける構成です。
比較軸 | Jev | Claude Code | Codex |
|---|---|---|---|
主な役割 | 狭い意味判断を型付きで返す | コード調査・編集・コマンド実行 | コード開発・レビュー・長時間タスク |
主な出力 | Choice、Score、Noul | 文章、コード、ツール呼び出し | 文章、コード、ツール呼び出し、成果物 |
自由文生成 | しない | する | する |
ファイル編集・実行 | しない | する | する |
得意な処理 | 分類、採点、検証、ルーティング | 対話的な開発、デバッグ、リファクタリング | 並列・長時間の開発、レビュー、知識作業 |
関係 | 判断部品 | Jevを呼び出す側になれる | Jevを呼び出す側になれる |
何がすごいのか — 速さ・安さ・扱いやすさ
Jevの価値は、一般的なLLMより「何でもできる」ことではありません。できることを判断へ絞り、その代わりにソフトウェアのループへ入れやすくした点です。
公式値は70〜500ms、100万入力トークン0.042ドル
TypeSafe AIは、Jevのエンドツーエンド応答時間を70〜500ミリ秒、価格を入力100万トークンあたり0.042ドルと公表しています。現行モデルのレート制限は毎秒25万トークン、毎分1,200リクエスト、コンテキストはリクエスト全体で64kトークンです。入力はテキストのみで、画像、音声、動画には対応していません。
発表記事では、特定のワークフロー評価で既存モデルより193.6倍高速、444.6倍安価だったとしています。ただし、これらはTypeSafe AI自身の評価であり、同社も「実運用で得られる改善の上限寄り」と説明しています。Jevの採用判断では、この倍率を一般化せず、自分のデータとネットワーク環境でレイテンシ、正解率、誤判定コストを測る必要があります。
質問を並列評価できる
同じstateに対する複数の質問は、1回のAPI呼び出しで並列に評価されます。問い合わせ文から「担当部署」「緊急度」「不満の強さ」を同時に得る構成なら、質問ごとに生成モデルを3回呼ぶ必要がありません。
TypeSafe AIの公開Cookbookには、GDPRの文書へ13問を投げた例で、質問を1回にまとめると回答を変えずに10.0倍高速、12.2倍安価になったという測定があります。これはそのCookbookの条件における結果で、あらゆる入力に同じ倍率が出る保証ではありません。
型エラーを防げても、判断ミスは防げない
Jevの出力候補は事前に定義されるため、アプリが期待しない形式や候補外の文字列を返す「型の破綻」は防げます。この意味では、生成モデルへJSON出力を頼み、検証と再試行を挟む構成を簡素化できます。
一方、TypeSafe AIが発表時に使った「hallucinateしない」という表現は、判断が常に正しいという意味ではありません。公式のjaggednessページには、文字どおりに解釈しすぎる、数字と日付に弱い、無関係な長文で精度が落ちる、入力内の敵対的な命令に影響される、といった失敗条件が列挙されています。形式の保証と内容の正しさを分けることが、Jevを安全に使う前提です。
何ができるようになるか — 5つの使いどころ
Jevを単独アプリとして探すより、既存のAIエージェントや業務システムの「判断待ち」を見つけると用途が見えます。
ツールとモデルのルーティング
ユーザーの依頼をChoiceで分類し、単純な検索は安価なモデル、設計判断は高性能モデル、危険な操作は人間確認へ送れます。Claude CodeやCodexの全ターンをJevへ任せるのではなく、次の担当を選ぶ入口として置く構成です。
RAGの候補選別と再ランキング
検索で集めた文書候補について、質問への関連性をNoulやChoiceで判定し、回答モデルへ渡す件数を絞れます。公式Cookbookでは、BM25で絞った法務文書候補を再評価し、検索順位を改善する例が公開されています。
実行前ガードと人間確認
返金、削除、外部送信などの操作前に、依頼内容とポリシーの一致度やリスクを評価できます。ただし、Jevの回答を認可そのものにしてはいけません。権限、金額上限、承認済みユーザーかどうかなど、確定的に判定できる条件はコードで強制し、Jevは意味判断の補助に使います。
品質評価と完了判定
生成モデルが作った回答やコード差分を、要件充足、根拠の一致、危険な変更の有無といった狭い問いに分けて評価できます。低信頼の結果だけ別モデルや人間へ送れば、すべてを高価なモデルで二重チェックする構成より処理量を抑えられます。
リアルタイムな操作選択
TypeSafe AIは、構造化されたゲーム状態から次の操作を選ぶDoomやWikiracingのデモを公開しています。画像を見て操作しているわけではなく、テキストやJSONで渡された状態から候補を選んでいます。この制約内なら、ブラウザ要素、機器状態、ワークフローの次アクションなど、短い周期で判断を繰り返す用途へ広げられます。
Claude Code・Codexで試す最短ルート
Jevの公式Skillは、Jev自体をClaude CodeやCodexへ内蔵するプラグインではありません。APIの3つの質問型、設計パターン、失敗条件をエージェントへ教え、正しい連携コードを書かせるための指示セットです。
まずPlaygroundで質問を1つ試す
TypeSafe AIのPlaygroundへログインし、stateに短い問い合わせ文を貼り、Noulで「緊急性があるか」を聞きます。ここでは正解率を判断せず、入力と出力の形を理解することが目的です。
次に同じstateへChoiceとScoreを追加し、複数質問が1回で返ることを確認します。実業務のデータを入れる前に、公開可能な例文で挙動を確認してください。
公式Skillをエージェントへ追加する
Claude Codeでは、公式ドキュメントに次の導入手順があります。
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Codexなど他のSkill対応エージェントでは、公式案内は次の形式です。
npx skills add typesafe-ai/skills --skill typesafe-ai
SkillはAPIキーを発行せず、権限も増やしません。Jevへ実際に接続するには、TypeSafe AIのキーを取得し、TYPESAFE_API_KEYとして安全な資格情報ストアまたは環境変数から渡します。プロジェクトのSkillファイルへキーを書かないでください。
公式API例を最小構成で動かす
次は公式Quick startに沿ったcURLの最小例です。問い合わせを3部署のどこへ送るかをChoiceで選びます。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "決済連携が3日間失敗しています。至急確認してください。",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "どの担当が処理すべきか",
      "criteria": {
        "billing": "請求または支払いの問題",
        "technical": "不具合または連携の問題",
        "sales": "価格または契約前の相談"
      }
    }
  }
}
EOF
日本語は公式に対応対象として挙げられていますが、英語が主要な学習言語で、CJKは同等精度ではないとされています。日本語で使う場合は、実データから正解付きの検証セットを作り、英語のデモ結果をそのまま当てはめない運用が必要です。
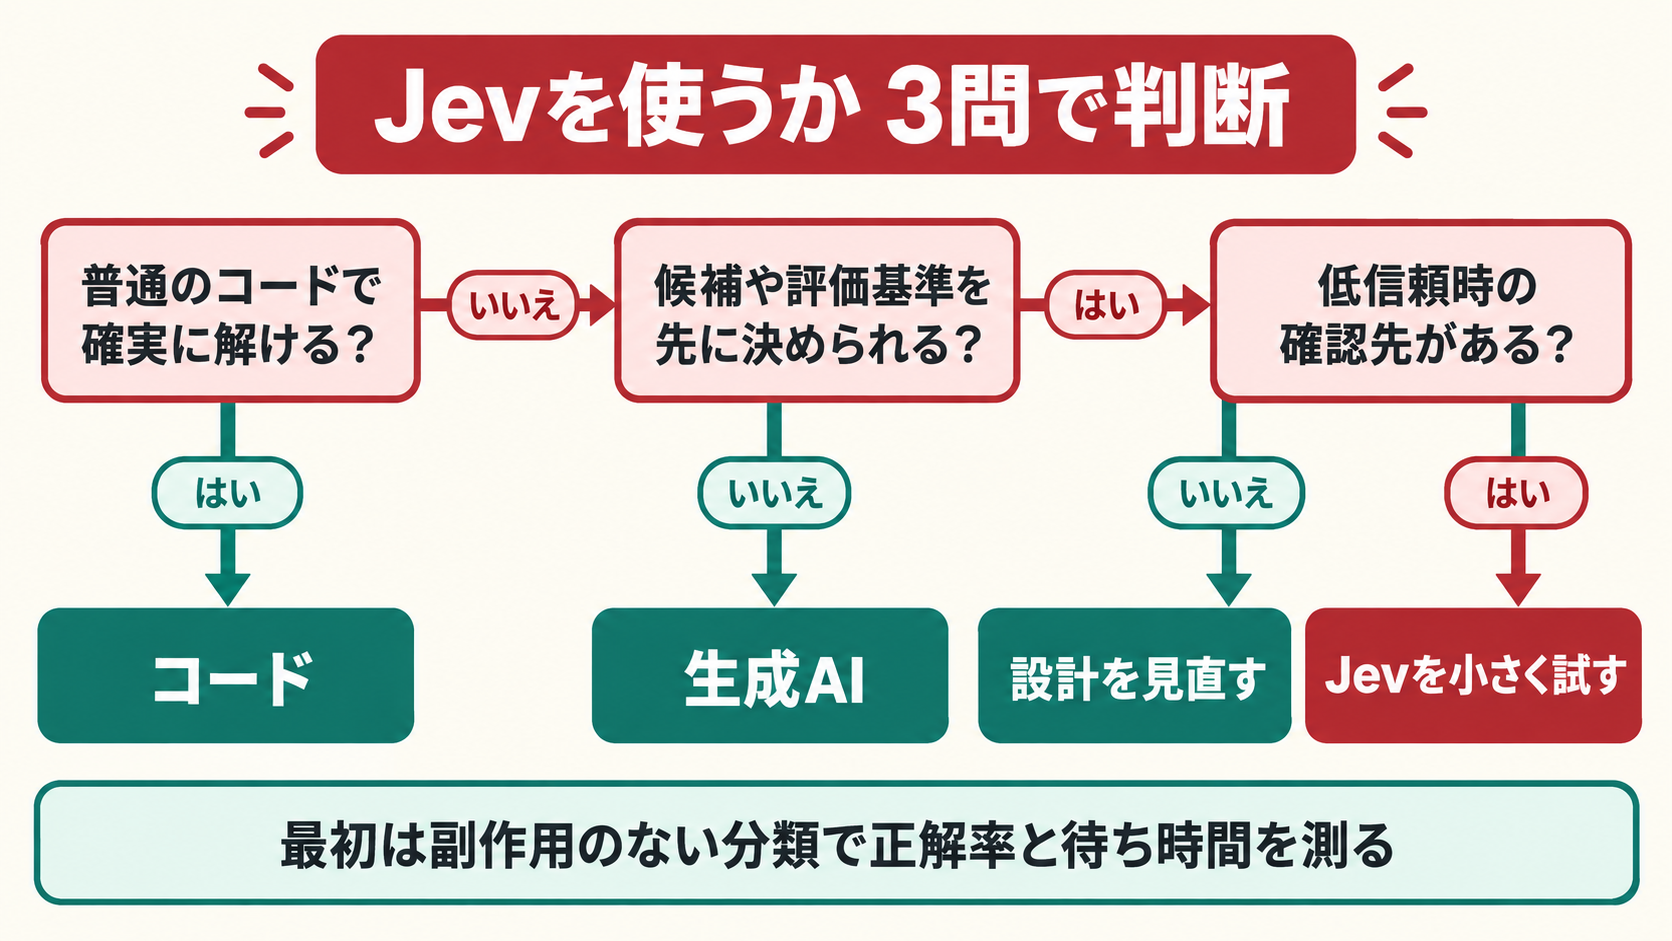
Jevを入れる前に、普通のコードで解けるか、回答候補を閉じられるか、低信頼時の退避先があるかを順に確認します。
【要注意】Jevで踏みやすい5つの失敗
新しいモデルだから広く使うのではなく、向かない処理を先に外したほうが安全です。
❌ Claude CodeやCodexの代替モデルとして設定する
⭕ 回避策: 文章生成、コード作成、ツール実行はClaude CodeやCodexへ残し、分類や評価だけをJevへ切り出します。Jevにはチャットやコード補完の機能がありません。
❌ 「幻覚しない」を「誤判定しない」と読む
⭕ 回避策: 候補外の型エラーが出ないことと、選択が正しいことを分けます。正解付きデータで精度を測り、低信頼時の確認経路を用意します。
❌ 計算や日付比較まで任せる
⭕ 回避策: 数値計算、件数、日付の前後、権限照合は通常のコードで処理します。Jevは「この文が緊急性を示すか」のような意味判断に限定します。
❌ 長いログや文書をそのまま渡す
⭕ 回避策: 検索やパーサーで候補を絞り、質問に必要な部分だけをstateへ渡します。公式ドキュメントは、無関係な情報が増えるほど精度が下がると説明しています。
❌ confidenceだけで高リスク操作を自動実行する
⭕ 回避策: 金銭移動、削除、外部公開は、信頼度が高くても確認や権限検査を省略しません。Jevは判断材料を返し、実行権限はアプリ側が持ちます。しきい値は用途ごとに検証し、読み取りと破壊的操作で同じ値を流用しないでください。
導入判断 — 置き換えるのは「生成AI」ではなく判断処理
Jevが適しているかは、次の4問で確認できます。
- その処理は、文章やコードを作るのではなく、分類・採点・真偽判定か
- 回答候補または評価基準を事前に定義できるか
- 誤判定した場合に、人間確認や別モデルへ戻す経路があるか
- 普通のルールや計算だけでは扱いにくい、言葉の意味判断が含まれるか
4つすべてが当てはまるなら、Jevを試す価値があります。正規表現やSQLで確実に解ける処理なら、そちらが速く、安く、説明もしやすい場合があります。自由文やコードが必要なら、Claude Code、Codex、または一般の生成モデルを使います。
Jevが広げるのは、AIに考えさせる範囲ではなく、これまで生成モデルへ雑に渡していた判断を、型と確率を持つ部品へ分解できる範囲です。まずは副作用のない分類を1つ選び、正解付きデータで測る。そこで精度と待ち時間が合えば、次の判断へ広げる順番が堅実です。
次に読むなら: Claude Code側のコンテキストと費用を減らしたい場合は「Claude Codeトークン節約術」で、コーディングエージェントの選び方は「Cursor vs Claude Code」で整理しています。
参考・出典
- Introducing System One Models & Jev — TypeSafe AI(https://typesafe.ai/blog/introducing-system-one-models-and-jev、参照日: 2026-09-24)
- Introduction — TypeSafe AI Documentation(https://docs.typesafe.ai/introduction、参照日: 2026-09-24)
- Jev with coding agents — TypeSafe AI Documentation(https://docs.typesafe.ai/introduction/coding-agents、参照日: 2026-09-24)
- Models — TypeSafe AI Documentation(https://docs.typesafe.ai/models、参照日: 2026-09-24)
- Quick start — TypeSafe AI Documentation(https://docs.typesafe.ai/introduction/quickstart、参照日: 2026-09-24)
- Confidence — TypeSafe AI Documentation(https://docs.typesafe.ai/confidence、参照日: 2026-09-24)
- Jev 1.13 jaggedness — TypeSafe AI Documentation(https://docs.typesafe.ai/model-jaggedness/jev-1.13、参照日: 2026-09-24)
- Agent skill — TypeSafe AI Documentation(https://docs.typesafe.ai/agent-skill、参照日: 2026-09-24)
- Claude Code overview — Anthropic(https://docs.anthropic.com/ja/docs/claude-code、参照日: 2026-09-24)
- Codex — OpenAI(https://openai.com/codex/、参照日: 2026-09-24)
- Jev is the fastest-adopted model in AI Gateway history — Vercel(https://vercel.com/blog/ai-gateway-jev-model-launch、参照日: 2026-09-24)