Claude Opus 5.5の更新点|性能・料金・設定を読み解く
代表取締役 上坂大地郎
Claude Opus 5.5が公開され、長い開発作業や資料分析に使うモデルの選択肢が増えました。試す前に押さえたいのは、性能の変化、料金の内訳、従来と異なる推論設定です。 Anthropicの発表ページの日付は2026年9月22日。本稿は日本時間9月23日に確認した公式資料に基づきます。公式発表。
- 入力・出力のAPI単価はOpus 5から20%低下し、キャッシュ読み取りは60%低下しました。発表の「40%低コスト」は、典型的な処理を使った同社の評価です。
- APIの推論設定はmediumが既定です。旧モデルと同じ設定を省略したリクエストでも、比較条件が揃うとは限りません。
- Claude Codeではv2.1.280以降が必要です。モデル名だけでなく、接続先と実際に選ばれたモデルを確認してください。
Claudeでコード修正や調査をしている人、API費用を見直したい開発者に向けて、変更点を整理します。読み終えたら、自分の環境で確認する設定と、試用結果を比較する項目を選べます。新モデルの実測レビューではなく、公式仕様の整理と、それに基づく評価手順の提案です。
Opus 5.5は、どの仕事の選択肢になるのか
長い作業を任せるモデルとして位置づけられる
公式モデル一覧は、Opus 5.5を長時間のエージェントによるコーディングと知識労働向けに位置づけています。文章・画像を入力し、文章を出力するモデルです。APIで指定するIDはclaude-opus-5-5、コンテキストウィンドウは100万トークン、最大出力は128Kトークンです。モデル一覧。
コンテキストウィンドウは、一度の処理で参照できる情報の枠と考えると分かりやすいでしょう。広い机なら資料を並べられますが、机が広いだけで資料の読み違いがなくなるわけではありません。長い仕様書やコードを扱うときも、何を調べ、どの成果物を返してほしいかは明示する必要があります。
同じ一覧では、難しい推論や長期のエージェント作業にFable 5.1を挙げています。Opus 5.5を高めの推論設定で評価しても要求に届かない場合の選択肢という説明です。モデルの系列名だけで一列に順位を付けるより、普段の作業をOpusで満たせるか、難しい仕事でFableが必要かを分けて考えられます。
改善の発表を、そのまま成果の保証にしない
Anthropicは、Opus 5.5で性能、処理効率、文章の分かりやすさを改善したと説明しています。一方、同じ発表の中で、ベンチマークの点差は実際の仕事の差を表す指標として以前ほど頼れないとも述べています。性能と評価条件。
利用者にとっては、正解に近い回答が出ることと、そのまま採用できる成果物になることの間に距離があります。コードなら既存の動作を壊していないか、調査資料なら出典へ戻れるか、要約なら未決事項を決定済みとして書いていないか。この最後の確認まで含めて比べるのが、本稿の提案です。
Fableの前回更新を追いたい場合は、Claude Fable 5.1とFable 5の違いも参照できます。今回のOpus更新とは別の出来事なので、導入日やモデル名を混ぜないようにしてください。
「40%低コスト」と料金表の20%差は、両立する
通常の入力・出力と、キャッシュを分ける
Claude Platformの料金表で確認できる標準の単価は次のとおりです。米ドル、100万トークン当たりで、月額プランの会費ではありません。キャッシュは、繰り返し使う入力の処理を再利用する仕組みです。公式料金表。
課金対象 | Opus 5 | Opus 5.5 | 同じ量を処理する場合の差 |
|---|---|---|---|
通常の入力 | $5 | $4 | 20%低下 |
出力 | $25 | $20 | 20%低下 |
キャッシュ読み取り | $0.50 | $0.20 | 60%低下 |
5分キャッシュ書き込み | $6.25 | $5 | 20%低下 |
1時間キャッシュ書き込み | $10 | $8 | 20%低下 |
「キャッシュは安い」とだけ覚えると、初回に作る費用と、後で読む費用を混同します。料金表には保存時間ごとの書き込み単価があり、読み取りとは別です。また、入力の共通部分を再利用するにはキャッシュが成立する条件があります。同じ資料を渡したつもりでも、請求上のすべての入力が読み取り単価になるとは限りません。キャッシュの仕組み。
単価だけ変わる場合と、処理量も変わる場合
想定シナリオとして、キャッシュを使わず、入力100万・出力10万トークンを処理するとします。上の単価だけで計算するとOpus 5は7.50ドル、Opus 5.5は6ドルで、差は20%です。これは計算例であり、実行して得た請求額ではありません。ツール等の追加費用も含めていません。
一方、発表の40%という値は、既定設定で典型的な作業を実行したAnthropicの評価結果です。単価の変更に加え、タスク当たりのトークン消費が少ないことも説明されています。したがって、表の20%と矛盾はしませんが、どの利用者にも40%の削減が生じるとは言えません。コスト効率の説明。
実際の比較では、安くなった単価に過去のトークン数を掛ける概算と、新モデルを動かして測る費用を分けましょう。後者は、出力の長さ、やり直し、ツール呼び出し、キャッシュの利用状況でも変わります。途中で失敗して再実行した分まで数えると、採用できる成果物を得るための費用が見えます。
料金を読むときは、次の3つを別々に確認すると整理できます。
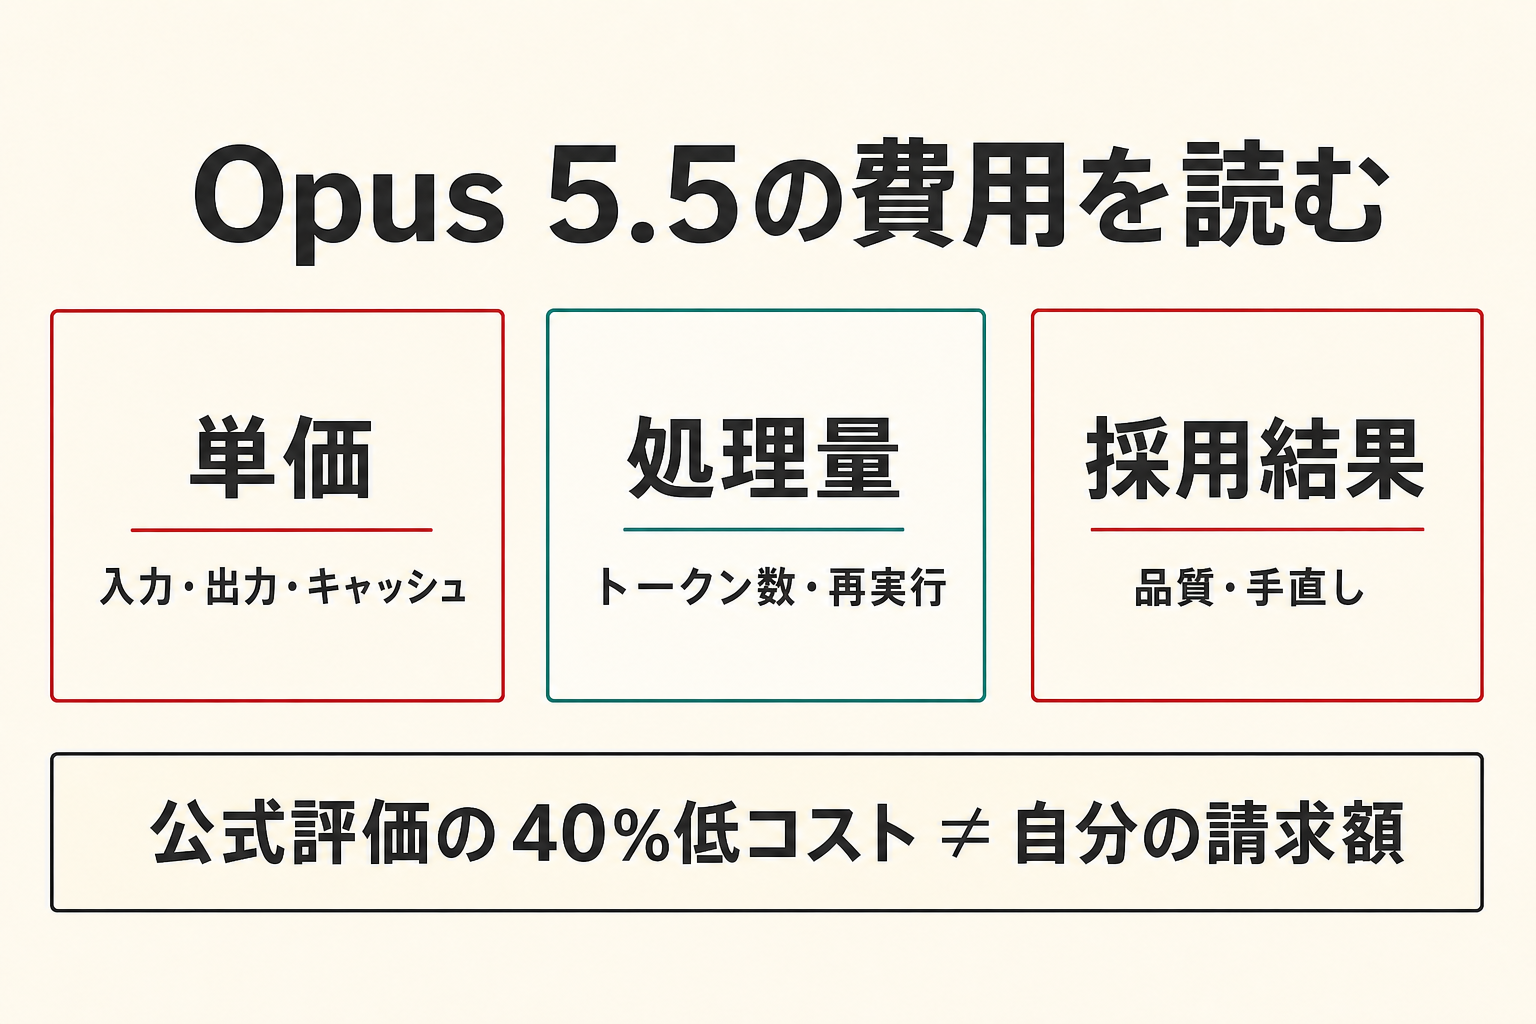
料金表だけでは、使える成果物が得られるまでの費用は決まりません。モデル更新後は、手直しと再実行も含めて同じ仕事を比較してください。
APIはモデル名と一緒に、推論設定を点検する
省略したeffortの意味が変わる
effortは、モデルが答えを考えるためにどれだけ処理を使うかを調整する設定です。公式資料では、Opus 5.5の既定値はmediumで、Opus 5の既定値はhighです。以前のリクエストでeffortを省略していた場合、モデル名だけを変えると、この条件も変わります。Effortの公式説明。
安くなったかを比べるだけなら、既定設定同士の比較にも意味があります。ただし、「モデルの変更以外は同条件」とは書けません。日常の既定設定での比較と、同じeffortを明示した比較を区別して記録すれば、後から結果を読み返せます。
thinkingを無効にする古い指定は持ち越さない
Opus 5.5はadaptive thinkingが常に有効で、公式資料はthinking: {"type": "disabled"}を指定したリクエストが400エラーになると説明しています。これは曖昧な品質差ではなく、移行前に確認できる互換性の注意点です。Opus 5.5の推論設定。
既存の設定ファイルやリクエスト生成処理で、モデル名、effort、thinkingの3項目を探してください。共通設定を使い回している場合は、一か所を書き換えるだけで別のモデルにも影響する可能性があります。ここではOpus 5.5用の設定を別に用意し、少量の入力で応答と使用量を確認することを勧めます。
設定を省略して動くことと、意図した設定で動くことも別です。障害時に戻す旧モデルの設定を残し、新旧どちらで実行したかを結果に添えておくと、内容の違いをモデル変更に結び付けて調べられます。
Claude Codeでは、更新後に選択結果を見る
必要なバージョンと接続先を確かめる
公式変更履歴のv2.1.280には、Opus 5.5の追加と既定のOpusモデルへの変更が記載されています。モデル設定資料も、このバージョン以降を必要条件としています。まずclaude --versionで確認し、必要なら利用環境の管理ルールに沿って更新します。公式の更新コマンドはclaude updateです。変更履歴、モデル設定。
opusという短い名前は、固定のモデルIDではなく別名です。接続先によって解決先が異なり、確認時点の公式表ではMicrosoft FoundryのopusはOpus 4.6となっています。「Opusを選んだ」だけで5.5を使ったと判断しないことが必要です。
試用だけなら、設定の保存先にも注意する
Claude Codeの/modelはモデル選択画面を開きます。公式資料では、選択画面でEnterを押すと新しいセッションの既定にも保存され、sなら現在のセッションだけ切り替えます。直接/model <モデル名>を入力する方法も、既定の保存を伴います。切り替え方法と保存動作。
普段のモデルを変えずに試したい場合は、選択画面の対象行でsを使う方法があります。キー割り当てを変更している環境では、画面の案内も確認してください。切り替えた後は/statusで現在のモデルを見てから、比較用の作業を始めます。
モデルが表示されない、または実行できない場合は、バージョンだけでなく、組織の許可設定と接続先を調べます。提供開始という発表と、自分のアカウントでの利用確認は別です。この記事では個別アカウントや日本の各クラウドリージョンでの動作までは検証していません。
比べるなら、使い慣れた仕事を小さく切り出す
読みやすさも、確認できる条件にする
ここからは公式の性能結果ではなく、利用者が評価するための提案です。最初は、すでに期待する結果が分かっている仕事を選びます。新しい難題だけを渡すと、以前より良くなったのか、たまたま解けたのかを判断しにくいためです。
たとえば文章の比較なら、結論が先にあるか、決定と未決を区別しているか、原文にない説明を足していないかを採点項目にします。「自然な文章になった」という感想だけでは、次回の評価者が変わったときに比較を続けられません。
試す仕事の例 | 同じ条件にするもの | 採用できたと判断する条件 |
|---|---|---|
小さな不具合の修正 | 開始時点のコード、再現手順、依頼文 | 再現テストが通り、関係のない動作を変えない |
資料からの回答作成 | 入力資料、質問、使用を許す情報源 | 数値と引用の参照箇所を確認できる |
会議メモの要約 | 元のメモ、出力形式、文字量の目安 | 担当・期限・未決事項を取り違えない |
この表は試験設計の例であり、Opus 5.5が各条件を満たすと確認した結果ではありません。入力に機密を含めるかは、利用サービスと所属先の取り扱いルールに従ってください。
速く終わっても、確認作業が増えたら記録する
モデルの応答時間だけでなく、採用するまでに人が直した時間も残しましょう。短い回答は読みやすい一方、必要な根拠が抜けていれば追加で質問することになります。コード修正も、変更行数が少ないこと自体を成功条件にはせず、必要な動作を保てたかを見ます。
比較用の記録には、実施日、モデルID、ツールのバージョン、effort、入力条件、合否、再実行回数、費用、手直し内容があれば始められます。同じ開始状態を用意し、旧モデルの回答を新モデル側へ渡さずに比較すると、先に出た答えを参考にした影響を減らせます。
コードの採否を具体化したい場合は、AI生成コードを人間がレビューする5つの観点も使えます。モデルを変えても、レビューで確かめる対象を揃えるためです。
安全性の改善後も、任せる範囲は明示する
Anthropicは、行動評価での改善やプロンプトインジェクションへの耐性向上を報告しています。ただし、これは同社の評価条件での結果であり、失敗が起きなくなったという意味ではありません。安全性の説明。
プロンプトインジェクションは、AIが読む文書などに紛れた指示で、元の依頼から動作をそらす攻撃です。通常の資料に見える入力を扱う作業でも、モデルの性能評価だけで権限を広げる判断は避けたいところです。
試用では、編集してよいファイルや使ってよいツールを決め、公開・送信などの戻しにくい操作は別の承認に分けることを勧めます。「テスト済み」という応答も、実行コマンドと結果で確かめてください。これはOpus固有の不具合を指摘するものではなく、評価結果を受け取る側の確認方法です。
今回の更新で最初に試せるのは、普段の一仕事を新モデルでやり直し、品質を満たした成果物に掛かった費用と時間を比べることです。モデルIDと推論設定を記録しておけば、良かった仕事だけ適用範囲を広げられます。請求の内訳をさらに調べる場合は、Claude APIのコスト最適化で、キャッシュや処理量の確認へ進めます。
参考・出典
- Introducing Claude Opus 5.5 — Anthropic、2026年9月22日発表(参照日: 2026-09-23)。性能・コスト効率・安全性は同社の評価として参照。
- Models overview — Claude Platform Docs(参照日: 2026-09-23)。モデルID、入出力、上限、用途の位置づけ。
- Pricing — Claude Platform Docs(参照日: 2026-09-23)。標準API料金とキャッシュ料金。
- Prompt caching — Claude Platform Docs(参照日: 2026-09-23)。キャッシュの再利用と書き込み・読み取り。
- Effort — Claude Platform Docs(参照日: 2026-09-23)。既定値とthinking無効化の制約。
- Claude Code CHANGELOG — Anthropic公式リポジトリ(参照日: 2026-09-23)。v2.1.280でのOpus 5.5対応。
- Model configuration — Claude Code Docs(参照日: 2026-09-23)。モデル選択、接続先別の別名、設定の保存、現在のモデル確認。