Grok 4.7で何が変わる?|提供先・料金と実務で比べる3つの条件
代表取締役 上坂大地郎
Grok 4.7を試すなら、まず使う場所を選び、品質・総費用・完了時間を同じ仕事で比べてください。標準APIの基本単価はGrok 4.6と同じですが、長く考えたり操作を繰り返したりする仕事の請求額まで同じとは限りません。 2026年9月21日、SpaceXAIが新モデルの提供を発表しました。公式発表。
押さえたい変更と条件は、次の3つです。
- Cursor・Grok Build・APIで提供開始。 Fast版は利用できる場所が異なります。
- 標準APIは100万トークンあたり入力2ドル・出力6ドルから。 長い入力には別の単価が適用されます。
- 評価はモデルと実行環境の組み合わせで変わります。 第三者の測定には、改善と同時に出力トークン増加や一部条件での後退もあります。
AIにコード修正や資料分析を任せている開発者、使うモデルの見直しを担当する人に向けて、発表内容と試し方を整理します。読み終えたら、自分の利用先で確認する料金条件と、切り替え前に比較する課題を選べます。仕様の確認日は2026年9月22日。以下の性能値は提供元・評価者の報告であり、この記事で日本語業務やAPI速度を独自に実測したものではありません。
4.7の発表で増えた選択肢を整理する
長い仕事を進めるモデルとして更新された
提供元は、Grok 4.7で基盤モデルを大きくし、長時間かかる難しい課題を重視して学習したと説明しています。作業の自己検証と長い文脈の扱いを改善したという位置づけです。これはモデルの設計・能力についての提供元の説明で、任せた仕事が無修正で完成する保証ではありません。開発内容の説明。
「長い仕事」は、返答の文章量だけを指しません。たとえばコードを読む、修正する、テスト結果を確認する、必要なら直すという一連の作業です。読者にとっては、その途中で指示を忘れたり、検証を省いたりする場面が減るかを確かめる意味があります。
公式Xの発表も確認できます。投稿時刻は日本時間9月22日午前1時17分で、公式サイトの日付は9月21日です。
音声認識や画像生成の新モデルとは別
Grok 4.7のAPIは文章・画像を入力し、文章を返すモデルです。コンテキスト枠は50万トークン。トークンは処理単位なので、「日本語を50万文字入れられる」という意味ではありません。Grok 4.7の仕様。
画像を読むことと画像を作ることも別です。公式のモデル案内では、画像・動画・音声には専用モデルやAPIがあります。文字起こしを検討している場合は、Grok Voice Transcribe 2.0の記事が対応する話題です。モデル別の用途。
また、Grokという名前だけで最新のX情報を自動取得すると考えないでください。APIで現在の情報を調べさせるには、検索ツールの利用が別に必要です。文書を読ませる試験と、WebやXを調べさせる試験では、入力も費用条件も変わります。
標準版とFast版は、利用先から選び分ける
APIで呼ぶ名前はgrok-4.7
公式ドキュメントのモデル名は**grok-4.7**です。既存のAPI連携で試すなら、設定先のモデル名だけでなく、返答を処理するコードや利用量の記録も一緒に確認します。使い慣れた環境で旧版との違いを測れば、操作画面が変わった影響を混ぜずに済みます。
利用先 | 確認できた提供内容 | 試す前の確認 |
|---|---|---|
公開xAI API | 標準の | アカウントのモデルアクセスと上限 |
Grok Build | 標準モデルとして利用。Fastも提供 | 無料枠はFastを含まない |
Cursor | 全プランで提供の案内。Fastも利用先に含む | 自分のプランの利用枠・請求条件 |
この表は公式の提供案内です。個々のアカウントでの表示・利用可否を実測した一覧ではありません。 APIの単価をそのままサブスクリプション全体の価格と読み替えないでください。提供先とFastの条件。
Fastは公開APIの別モデル名ではない
Fastは同じモデルを速い基盤で提供する選択肢ですが、公式ドキュメントではCursorとGrok Buildに限定され、公開xAI APIには提供されていません。推測したgrok-4.7-fastという名前をAPIへ指定する手順は使わないでください。
Fastを検討する目的も先に決めておきましょう。対話しながら修正する仕事では待ち時間を短くしたい一方、翌朝までに終わればよい処理では別の判断になります。利用先・待てる時間・予算を決めると、速度の宣伝だけで選ばずに済みます。
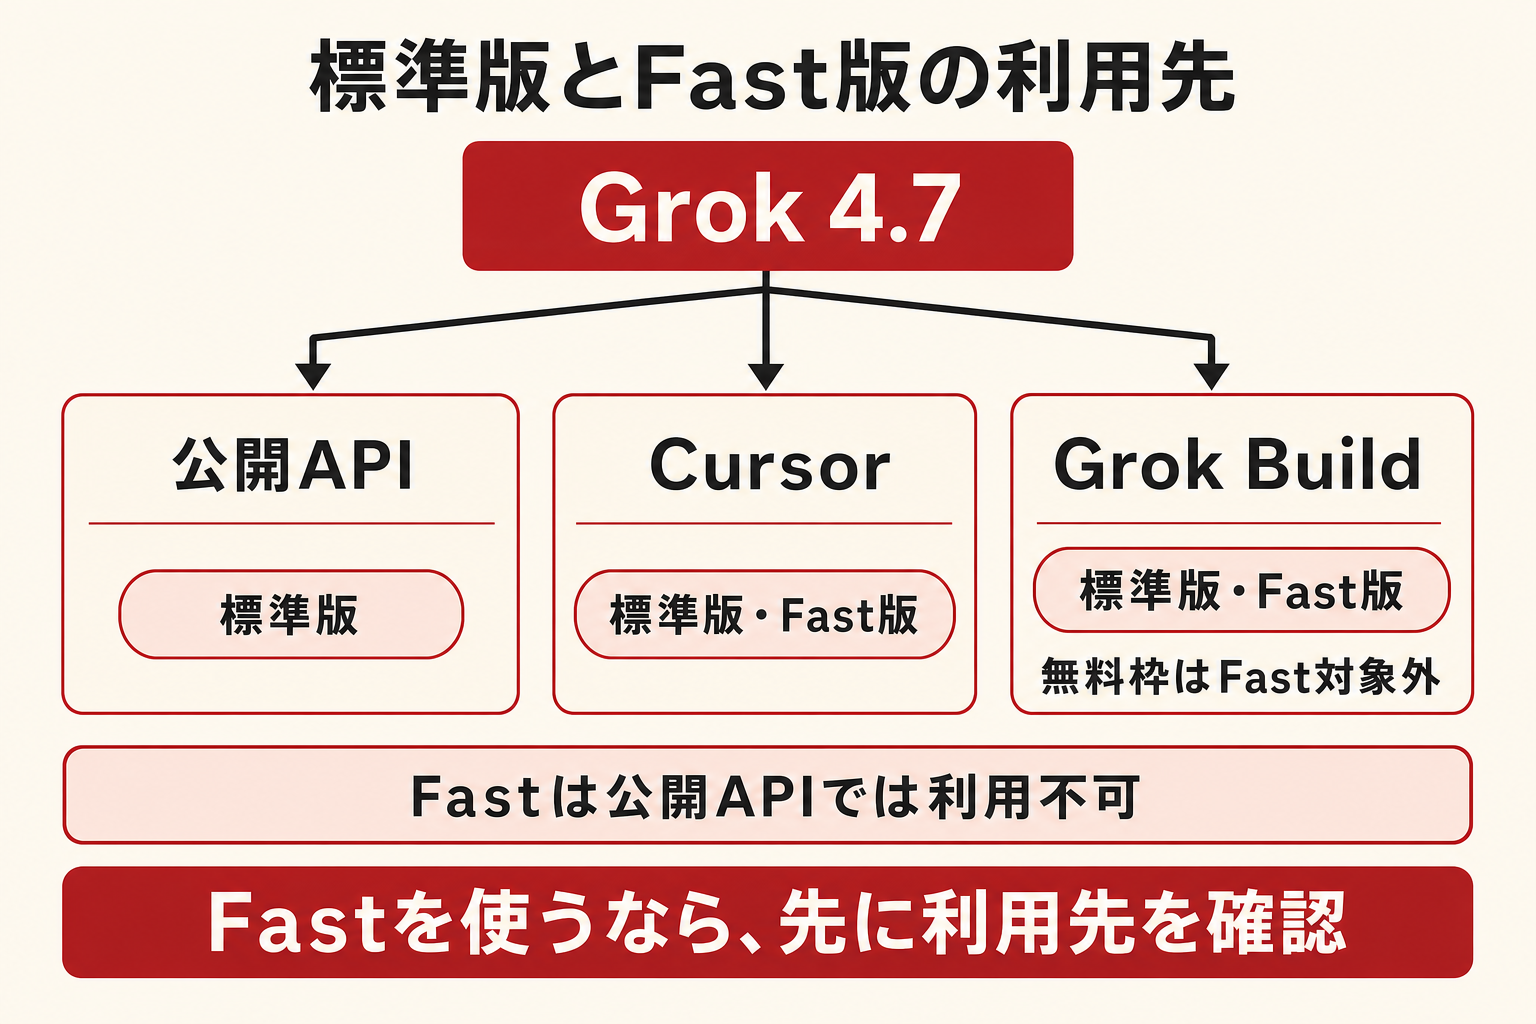
速い版を使いたいときは、先に利用先を確かめます。APIとアプリの選択肢を混ぜると、使えないモデル名や誤った料金見積もりにつながります。
料金表は20万トークンの境界まで読む
長文料金はリクエスト全体にかかる
標準APIの料金は、プロンプトの長さによって変わります。キャッシュ入力は、以前処理した入力を再利用できた部分に対応する料金です。毎回すべての入力がキャッシュ料金になるわけではありません。料金表、キャッシュの仕組み。
標準APIのプロンプト長 | 通常入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
20万トークン未満 | 2ドル | 0.50ドル | 6ドル |
20万トークン以上 | 4ドル | 1ドル | 12ドル |
単位はいずれも100万トークンあたり・米ドルです。公式表の長文料金は、境界を超えた部分だけでなく、そのリクエストの全トークンに適用されます。大量のファイルをまとめて渡す設計では、入力の増加と単価の変更を分けて見積もる必要があります。
Fastについては、公式の総論が「標準の2倍」とする一方、料金ページの長文欄は標準長文単価の単純な2倍になっておらず、境界の表記にも差があります。長文のFast料金は一律2倍で計算せず、利用先の表示と課金条件を確認してください。 この記事では不一致を推測で補いません。
単価が据え置きでも、完了までの費用は変わる
想定シナリオとして、通常入力1万トークン、出力2千トークンを1回処理する場合を考えます。標準API・20万未満・キャッシュなし・検索なしなら、入力0.02ドルと出力0.012ドルで、トークン料金は0.032ドルです。出力の2千には課金される推論分も含める前提で、税や外部サービスの利用料は含めていません。
同じ単価でも、修正のために何度も呼べば合計は増えます。料金を比べる単位は「1回の返答」だけでなく、合格した成果物を1つ得るまでに広げてください。短い返答で一度失敗する場合と、長く考えて一度で終わる場合のどちらが安いかは、呼び出し回数だけでは決まりません。
推論量も比較条件です。Grok 4.7はlow・medium・high・xhighを選べ、既定はhighです。推論トークンも費用に関係するため、画面に見える最終回答の長さだけで使用量を推定しないほうがよいでしょう。推論の設定と利用量。
好成績の数字にも、環境と設定が付いている
提供元の表を実務の改善率に変換しない
公式発表のCursorBench 4.0は、Grok 4.7が46.3%、Grok 4.6が40.4%です。ただし表の設定は4.7がxHigh、4.6がHigh。同じ表でFable 5.1 Maxは51.8%であり、4.7が全比較対象を上回ったわけでもありません。公式の評価表。
ここから「自分の開発作業も同じ割合で速くなる」とは計算できません。何を解かせたか、考える量、操作できる道具、打ち切り条件が手元と違うためです。ベンチマークは試す候補を選ぶ材料として読み、採用判断は仕事の合格条件に戻してください。
第三者評価は改善と負担を両方報告している
Artificial Analysisは、4.7をxhighで評価し、長い知識労働やGrok Buildを使うコーディングの改善を報告しています。一方、Intelligence Indexの1課題あたり出力は約8.1万トークンで、比較対象の4.6 highは約3.6万でした。出力単価の低さと、使う総量の少なさは別だと分かります。Artificial Analysisの測定。
この比較も推論設定が違います。平均値をそのまま自社の1件単価として予算表に入れるのではなく、長くなる仕事がどれかを探す手掛かりにしてください。同評価のCoding Agent IndexはGrok Buildとの組み合わせで測っており、モデル単体の性能と同一視できません。
さらにXBOWの初期候補モデルの検証では、Buildを使う構成で4.6から改善した一方、既存の別構成では一部後退しました。これは限定したセキュリティ課題の評価で、一般業務全体の優劣を確定するものではありません。それでも、モデルの差し替えと、モデルを動かす仕組みの変更を分けて試す理由になります。XBOWの検証条件と結果。
実行環境を表す「ハーネス」は、モデルへ道具を渡し、操作結果を返し、次の作業へつなぐ仕組みです。同じ担当者でも、作業台や使える道具が変われば進め方が変わる、と考えると近いでしょう。
手元の比較は、小さな不具合修正から始める
成功条件を入力より先に用意する
以下は編集部作成の想定シナリオです。モデルの出力例や実測結果ではありません。小さな数値処理の不具合を題材に、コードの修正とテストの作成をまとめて依頼します。
次のJavaScript関数を修正してください。
function median(a) { a.sort(); return a[a.length / 2]; }

要件:
- 有限の数値だけを含む配列を受け取る
- 昇順に並べた中央の値を返す
- 偶数個なら中央2つの平均を返す
- 空配列ならnullを返す
- 入力配列を変更しない
- 実装と、要件を確認するテストを提示する
- テストを実行していない場合は、その旨を書く
採点側では、[2, 10, 3]の期待値は3、[1, 2, 3, 4]は2.5、空配列はnullと先に決めます。加えて、呼び出し前後で入力配列が変わらないかを確認します。AIの説明が自然かだけを見るより、違いを具体的に記録できます。
これは高度な開発能力を測るための難問ではありません。モデル名・設定・記録の流れが正しいかを確かめる入口です。この課題が通っただけで大きなリポジトリへ移行できるとは判断せず、次に普段失敗しやすい小さな仕事を追加してください。
モデルの比較と環境の比較を別にする
まず同じ環境で4.6と4.7に同じ課題を渡します。推論設定と利用できるツールを記録し、片方だけに追加説明を与えた場合は別試験として残してください。失敗を修正した最終結果だけで比較すると、途中の手間が消えてしまいます。
次に、必要なら4.7を別の実行環境で試します。この順なら、改善がモデル由来なのか、道具や作業手順との相性なのかを考えやすくなります。実行時間に上限を設けた場合は、時間切れも結果に含めます。
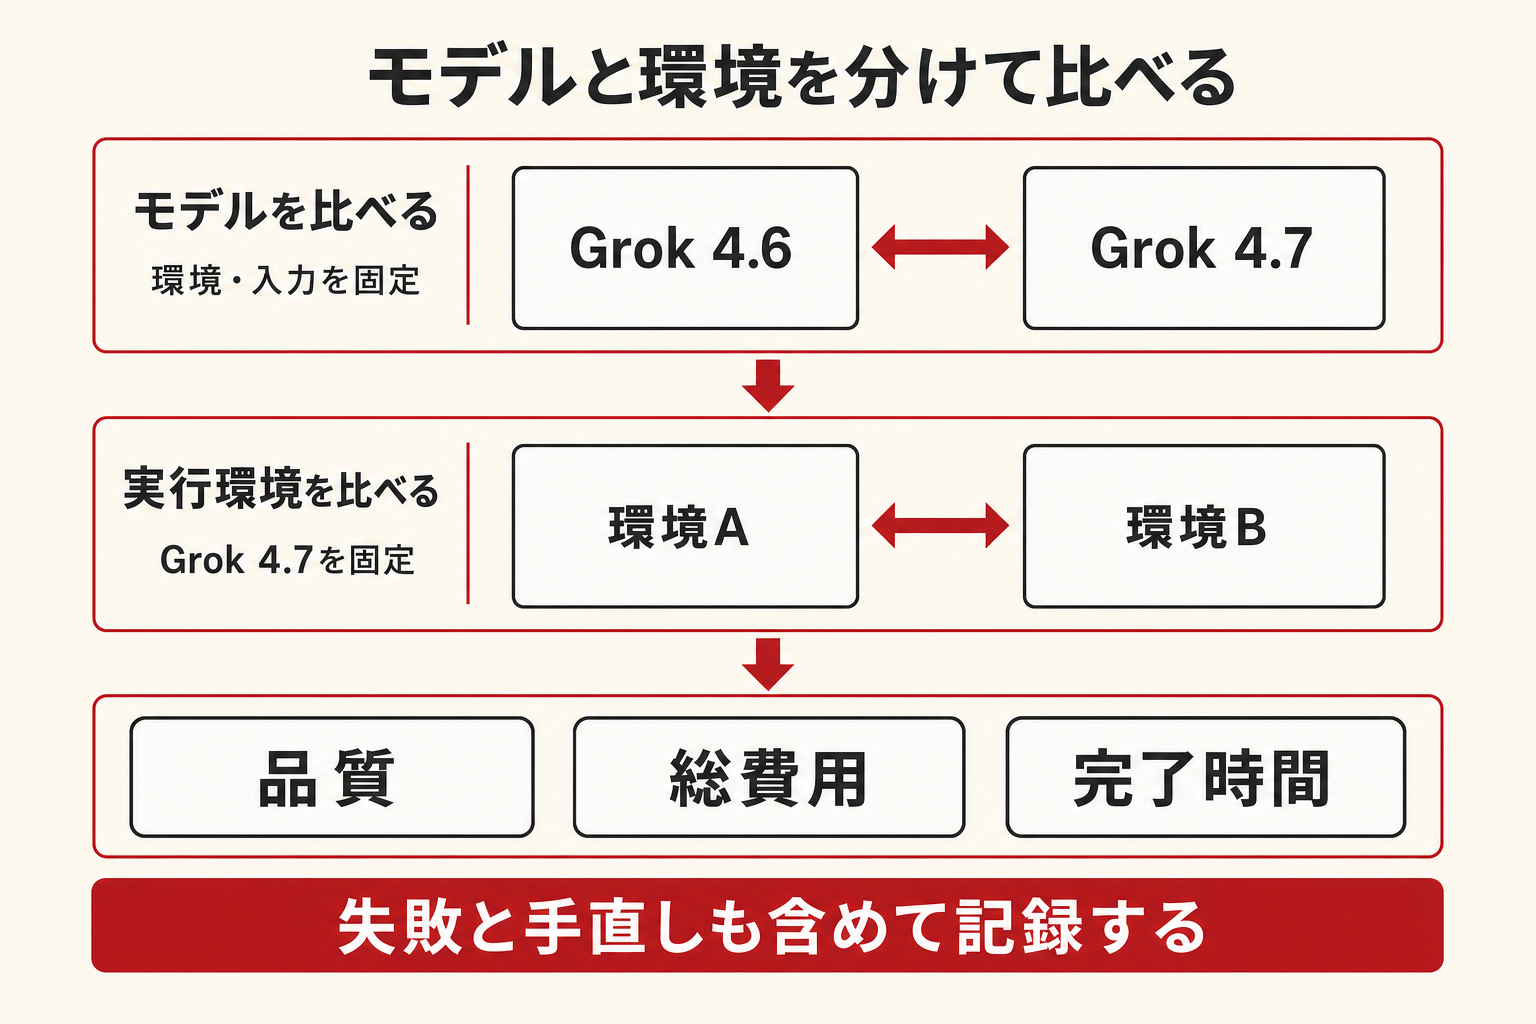
モデルと実行環境を同時に変えると、改善した理由が分かりにくくなります。切り替える要素を分けると、次の仕事にも使える記録が残ります。
品質・総費用・完了時間を1枚に残す
比較用の記録は、次の表から始められます。値を埋める前に、誰が合否を決めるかも決めてください。コードならテストと差分、資料なら元データとの一致や欠落を評価対象にします。見栄えと内容の正しさは別欄にしてもよいでしょう。
条件・結果 | 記録する内容 | 判断するときの読み方 |
|---|---|---|
試験条件 | モデル、推論設定、利用先、入力、ツール | 変更点が混ざっていないか |
品質 | 合格した要件、失敗、未実行の確認 | 自己申告だけで合格にしない |
総費用 | 入出力・推論・キャッシュ・ツールの料金 | 手直しと再実行も含める |
完了時間 | 開始から合格まで、人の作業時間 | 回答速度と完了時間を分ける |
同じ課題を複数回試す場合は、入力と合格条件を固定します。良かった回だけ選ばず、失敗した回の状態も残してください。最初から大きな平均値を作るより、「テストは通るが入力を書き換える」「資料は整うが出典を落とす」といった失敗の種類が分かると、任せる範囲を決めやすくなります。
コードの採用時は、人間が確認するレビュー観点も使えます。モデルにテストを作らせた場合でも、そのテストが要件を十分に覆っているかは別に確認してください。
切り替える範囲は、得意な仕事から決める
今回の発表は、既存のAIコーディング環境に新しい候補を加えるものです。手元で試す価値はありますが、評価原著の結果だけを理由に全処理を同時に変更する必要はありません。
まず、提供先で標準版を利用できるか確認し、比較表を1課題分埋めてみてください。品質が同等で完了時間が短くなるなら、その種類の仕事を次の候補にできます。逆に、文章は詳しくなるのに手直しが増えるなら、その仕事の切り替えは保留する判断もあります。
Fastを選ぶ判断は、その後で十分です。待ち時間が支障になる仕事を特定してから、標準版との費用差を確認します。自分の入力で、何が終わり、いくらかかり、どこを直したか。 その記録が、Grok 4.7を継続して使う範囲を決める材料になります。
参考・出典
- SpaceXAI「Introducing Grok 4.7」https://x.ai/news/grok-4-7(参照日: 2026-09-22)。発表日・モデル更新・提供元の評価。
- SpaceXAI公式X投稿 https://x.com/SpaceXAI/status/2102069815225586149(参照日: 2026-09-22)。公開の埋め込み用データで本文・投稿日時を確認。
- SpaceXAI Docs「Grok 4.7」https://docs.x.ai/developers/grok-4-7(参照日: 2026-09-22)。仕様・提供先・Fastの制限。
- SpaceXAI Docs「Pricing」https://docs.x.ai/developers/pricing(参照日: 2026-09-22)。標準・長文料金、Fast料金の表記差。
- SpaceXAI Docs「Models」https://docs.x.ai/developers/models(参照日: 2026-09-22)。用途別モデルと検索ツールの条件。
- SpaceXAI Docs「Reasoning」https://docs.x.ai/developers/model-capabilities/text/reasoning(参照日: 2026-09-22)。推論設定・利用量。
- SpaceXAI Docs「Prompt Caching」https://docs.x.ai/developers/advanced-api-usage/prompt-caching(参照日: 2026-09-22)。キャッシュの扱い。
- Artificial Analysis「Benchmarking Grok 4.7」https://artificialanalysis.ai/articles/benchmarking-grok-4-7(参照日: 2026-09-22)。評価者による実測報告。
- XBOW「Grok 4.7 Is Different. So Is the Best Way to Use It.」https://xbow.com/blog/grok-4-7-offensive-security-evaluation(参照日: 2026-09-22)。初期候補の評価と実行環境による違い。