Grok Voice Transcribe 2.0|料金と移行の注意点
代表取締役 上坂大地郎
録音の文字起こしに、新モデル「Grok Voice Transcribe 2.0」を選べるようになりました。料金は旧版と同じですが、既存のAPI呼び出しがどの版を使うかは、モデル名を明示して確認する必要があります。 SpaceXAI(xAI)の発表記事は2026年9月18日付です。公式発表。
押さえたいのは次の3点です。
- 音声1時間あたり、録音ファイルの処理は0.10ドル、ストリーミングは0.20ドル。 公式料金表に掲載されたAPIの単価です。
- 精度向上の評価は、対象の音声と測り方をセットで読む。 日本語の社名や、手元の会議録音での改善を保証する値ではありません。
- 移行期間の既定モデルは、公式資料間で記述が異なります。 新版を試す呼び出しでは
grok-voice-transcribe-2.0を指定します。
対象は、会議・インタビュー・問い合わせ音声の文字起こしを組み込む開発者と、既存ツールの見直しを担当する方です。読み終えたら、料金の見積もりと、日本語音声で確認する項目を用意できます。仕様の確認日は2026年9月20日。この記事のAPI例は公式資料に基づくもので、実際の音声を送信した速度・精度の検証は行っていません。料金表、API資料。
9月18日の発表と、APIの提供開始を区別する
新しくなったのは音声を文字へ変えるモデル
Grok Voice Transcribeは、音声を入力して文字を返すSpeech to Text(STT)のモデルです。録音を聞いて書き取る係、と考えると用途をつかみやすいでしょう。文字から返答を考える処理や、その返答を声で読み上げる処理とは分けて扱います。
2.0では、騒音や会話の重なり、短い発話などを含む音声での認識改善が打ち出されました。これはチャット用のGrok 4.6の新世代という意味ではありません。既存の音声処理をどこまで置き換えられるかが、今回の発表を読む出発点です。公式発表。
日付が異なる資料を、同じ出来事にまとめない
確認先 | 記載された日付・内容 | 読み取り方 |
|---|---|---|
APIリリースノート | 9月17日、2.0を利用可能と案内 | API提供の記録 |
発表記事 | 9月18日、新モデルの評価・機能・料金を説明 | 発表日として扱う |
現行のSTT資料 | 9月20日の確認時点で両モデルを掲載 | 呼び出し時の指定方法を確認する資料 |
日付は各ページの表記に沿っています。APIノートには提供開始の時刻やタイムゾーンが示されていないため、日本時間の開始時刻までは確定できません。「9月18日に初めてAPIが使えるようになった」とまとめると、前日の提供記録を落としてしまいます。リリースノート。
利用経路として確認したのはAPIです。Grokアプリの全プランや、日本の全アカウントへの一律提供を、この発表から推定することはできません。契約や地域による利用可否は、使うアカウント側で確認してください。
「精度2倍」を日本語会議の成績に置き換えない
提供元の評価と、外部の測定結果がある
SpaceXAIは、2.0の精度を旧版の2倍と表現しています。また、自社の短い発話を集めた評価では、単語誤り率が20.6%から6.8%へ下がったと報告しています。この評価セットは19言語の短い音声コマンドを対象にしたものです。全言語、全録音で同じ改善が出るという意味ではありません。公式発表の評価説明。
単語誤り率(WER)は、正解の書き起こしに対して、単語の置換・抜け・余分な挿入がどれだけあるかを見る指標です。低いほど誤りが少ない一方、「WERが一定量下がった」と「正解率が2倍になった」は同じ言い方ではありません。
外部評価を行うArtificial Analysisも、9月18日の自社X投稿で、AA-WER Streamingの最終文字起こしと最初の途中結果の精度について首位を報告しています。投稿には、最終文字起こしのWER 2.7%、発話終了後の時間 0.49秒という値が載っています。これは評価主体の測定報告であり、この記事で再測定した結果ではありません。Artificial Analysisの報告。
精度と待ち時間は、評価条件と一緒に読む
同評価の方法論は、約8時間の音声を使い、AA-AgentTalk、VoxPopuli、Earnings22という3つのデータセットを重み付けして集計するものです。発話をどこで終わりと判定するか、途中結果と確定結果のどちらを採点するかも定義されています。AA-WER Streamingの方法論。
したがって0.49秒を、アプリでマイクに話し始めてから全文が返るまでの時間や、長い録音の処理時間として扱うのは誤りです。録音ファイルのアップロード、通信、後続の要約まで含めた所要時間は、使う環境で別に測ります。
日本語では、専門用語の表記や数字の読み取りも確認したいところです。文章全体が読みやすくても、人名や日付だけが違えば、そのまま議事録へ渡せない場合があります。一般的な精度の順位と、業務で困る誤りの少なさは別々に確かめる、というのが本記事の推奨です。
録音の処理とライブ字幕では、料金も設計も違う
料金表の「1時間」は音声の長さ
公式料金表のSTTは、REST経由が音声1時間あたり0.10ドル、ストリーミングが0.20ドルです。RESTは録音ファイルなどをリクエストで送る方式、ストリーミングは音声を少しずつ送り、結果を受け取る方式です。発表記事は、話者分離・タイムスタンプ・キーワード指定を含めて旧版と同じ料金としています。API料金表、発表記事。
処理方式 | 公式単価/音声1時間 | 想定シナリオ:100時間分の単純計算 | 用途の例 |
|---|---|---|---|
録音ファイルなどをRESTで処理 | 0.10ドル | 10ドル | 会議後の文字起こし |
ストリーミングで処理 | 0.20ドル | 20ドル | 会話中の字幕・文字入力 |
100時間の欄は「音声時間×公開単価」で計算した例で、請求実績ではありません。要約モデルや音声保存、アプリの実行費用は含めていません。完成した議事録までの費用を比べるなら、文字起こしの料金と後処理の料金を分けて記録します。
安い方式を選ぶ前に、文字が必要なタイミングを決める
会議が終わってから原稿を作るなら、録音ファイルをまとめて送る構成が候補になります。一方、話している最中に文字を見せたいなら、途中結果を表示し、その後の確定結果で更新する設計が必要です。これは単価だけでは決められません。
たとえば、想定シナリオとして動画の字幕を後付けする場合、必要なのは認識した文字と音声内の位置です。会話中の入力補助なら、表示がどの程度書き換わるかも使い心地に関わります。同じ音声でも、用途に応じて合格条件を変えます。
自動で2.0へ移ったと決めつけず、モデル名を残す
既定値の記述は、3つの資料で揃っていない
9月20日の確認時点では、公式資料に次の差異がありました。
資料 | モデルを省略した場合・移行についての記述 |
|---|---|
9月17日のリリースノート | 既定は1.0 |
9月18日の発表記事 | 2.0は近日中に既定となり、1.0は今後数週間で廃止予定 |
現行のSTT資料 | モデルを省略した場合の既定は2.0 |
ここから、すべての利用者で切り替えが完了した時刻までは判断できません。2.0を比較したいときは、modelを省略しないのが実務上の対処です。旧版を使う場合はgrok-voice-transcribe-1.0を指定する案内がありますが、その指定で無期限に利用できるわけではありません。API資料、リリースノート、発表記事。
既存の処理を調べるときは、設定ファイルだけでなく、実際のリクエストで送っている値も確認します。ライブラリの既定値や別の設定が適用されていれば、ファイルを読んだだけでは比較条件を取り違えるためです。
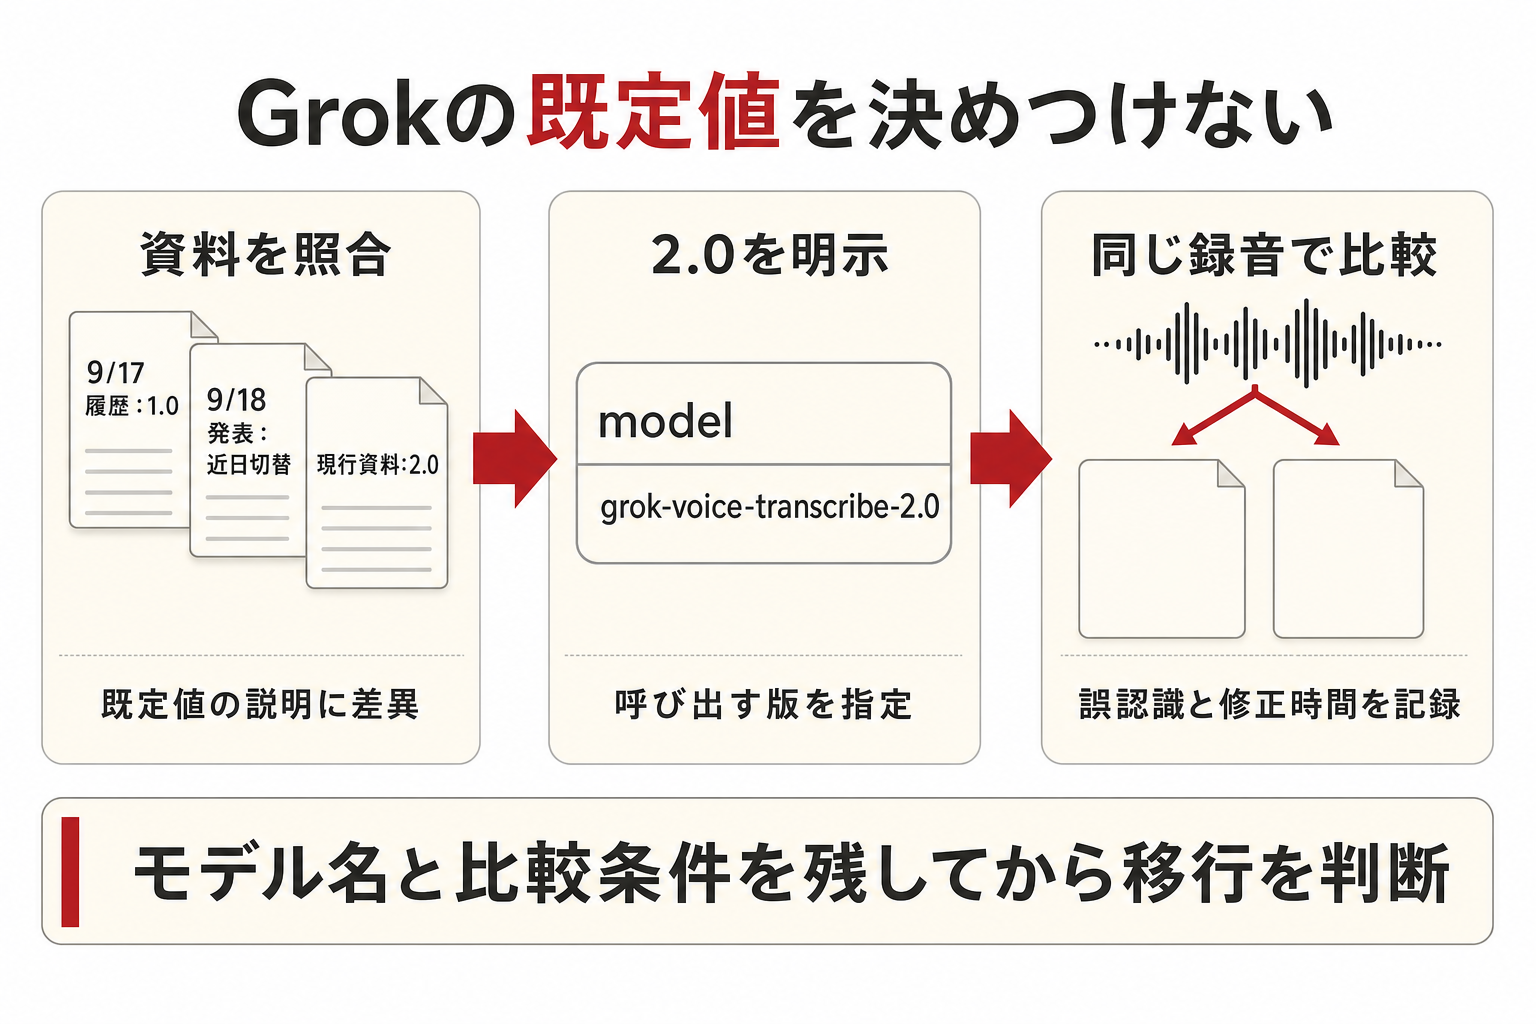
モデル指定を省略すると、評価した版を後から追いにくくなります。新版を試す呼び出しを分け、移行の判断に使った録音と設定を残します。
日本語ファイルを試す、最小限の呼び出し例
以下は、公式のREST例を日本語の録音用に組み替えたものです。API資格情報と送信してよいsample-ja.wavを用意した環境で使います。未実行のサンプルであり、成功レスポンスの実測例は掲載していません。
curl --fail-with-body --max-time 120 \
  https://api.x.ai/v1/stt \
  -H "Authorization: Bearer ${XAI_API_KEY}" \
  -F 'model=grok-voice-transcribe-2.0' \
  -F 'language=ja' \
  -F 'format=true' \
  -F 'diarize=true' \
  -F 'keyterm=Kubernetes' \
  -F 'file=@sample-ja.wav' \
  -o transcript-2.0.json
ファイルの項目は、公式資料の指定どおりほかのフォーム項目より後に置きます。language=jaは、format=trueと組み合わせて日本語の数字などの整形に使う指定です。「これを付けないと日本語を認識しない」という意味ではありません。STTのパラメータ仕様。
diarize=trueは話者を分ける設定です。話者番号が付いても実名との対応まで確認できたとは限らないため、誰の発言かが重要なら音声と照合します。keytermは固有名詞などの認識を誘導する指定で、例ではKubernetesを渡しています。これも正しく書き起こすことの保証ではありません。
120秒はこのサンプルで設定した待ち時間の上限で、サービスの処理時間を示す値ではありません。タイムアウトしたときは、保存ファイルの有無だけで成功を判定せず、終了コードや返されたエラーを確認します。録音が長い場合に適した上限値は、別途検証してください。
保存されたJSONを見る際は、文字起こしの本文であるtextと、音声の長さを示すdurationを区別します。durationはAPIが返すまでの処理時間ではありません。単語ごとの情報はwordsに入り、開始・終了時刻を手掛かりに元音声の該当箇所へ戻れます。レスポンスの仕様。
最初の試行で確認したいのは、JSONを保存できたかだけではなく、後から誤りを直せるかです。想定シナリオとして製品名を読み違えていたら、前後の音声と照合し、必要なら用語指定を変えて再比較します。その際も、修正前の出力は残してください。どの設定で改善したのかを追う材料になります。
日本語の録音では、読みやすさ以外の誤りを拾う
同じ入力で、旧版と新版を比較する
最初の比較では、録音・モデル以外のパラメータ・採点対象を揃えます。2.0だけに専門用語を渡した場合、モデルの改善と設定の効果を分けられません。新版の能力を調べる比較と、設定を工夫して業務に合わせる比較を、別の実験として残すことを勧めます。
想定シナリオとして、技術打ち合わせの一部を使うなら、社名や製品名、日付、数値、発言者が切り替わる箇所を人が先に確認しておきます。録音を送信できない場合は、同じ語を含む検証用音声を作る方法もあります。ただし、検証用の読み上げ音声で合格しても、実際の会議で同等とは扱いません。
比較結果は、次のような記録票へ残せます。これは本記事で提案する評価項目であり、提供元のベンチマークではありません。
音声ファイル名/長さ/録音条件:
送信したモデル名/実行日時:
language・format・diarize・keytermの指定値:
社名・人名・製品名の誤り:
数字・日付・否定表現の誤り:
発言の抜け/音声にない語の追加:
話者の取り違え:
人が修正するのにかかった時間:
リクエスト開始から応答までの時間/エラー:
今回の用途での採用・保留と、その理由:
整形と要約を重ねる前に、書き起こしを確認する
文字起こしの出力を、そのまま別のAIへ要約させる場合もあるでしょう。その前に、原文と整形後の文字を比較できる状態にしておきます。日付の認識が違っていたのか、後の要約で変更されたのかを切り分けられるためです。
特に残したいのは、間違うと判断が変わる言葉です。想定シナリオでは「対応する」と「対応しない」、「今月」と「来月」のような箇所が該当します。文章の自然さだけで合否を付けると、こうした違いを見逃しかねません。
文字起こし後の出力を議事録へ整えるときも、まず原文を確認し、その後に要点や担当者を整理します。段階を分けて試すと、修正が必要な工程を特定しやすくなります。
記録票には、良かった出力だけでなく失敗した入力も残します。録音条件ごとに結果が違うなら、「全件を切り替える」以外に、聞き取りやすい録音から段階的に試す選択肢もあります。比較を行う前に、どの種類の誤りなら保留にするかを決めておくと、文章が自然だから採用するという判断を避けやすくなります。
Loomからコードへ渡す活用例も、入力確認が先
発表記事と公式Xでは、Loomで録った変更依頼を文字起こしし、Cursorへ渡す使い方が紹介されています。Atlassianが従来の方式より指示を正確に捉えられたとする評価も掲載されていますが、これは当事者の説明です。利用者全体で同じ効果が出たという独立検証ではありません。公式の活用例。
この使い方から取り入れやすいのは、「話した内容を開発指示の下書きへ変える」という部分です。想定シナリオとして画面修正を依頼するなら、対象画面、変更する要素、残す挙動を録音の中で分けて説明し、文字起こしを確認してからコーディングツールへ渡します。
音声に含まれるあいまいな指示が、文字になっただけで明確になるわけではありません。たとえば「ここのボタン」という表現は、音声だけでは対象が伝わらない可能性があります。画面名や要素名を補い、意図と違う書き起こしがあれば、その段階で直します。
まず手元の録音で、修正時間が減るかを確かめる。 料金とベンチマークは試す理由になりますが、切り替えの理由は自分の入力で残した比較結果です。会話への音声応答まで含める構成を検討する場合は、GPT-Live-1のAPI解説で、文字起こし単体との役割の違いも確認できます。
参考・出典
- Introducing Grok Voice Transcribe 2.0 — SpaceXAI、2026年9月18日付。改善値と導入事例は提供元の主張として参照(参照日: 2026-09-20)。
- Release Notes — SpaceXAI、9月17日のAPI提供記録・当時の既定モデル(参照日: 2026-09-20)。
- Speech to Text — SpaceXAI、モデル選択・日本語指定・RESTパラメータ(参照日: 2026-09-20)。
- API Pricing — SpaceXAI、RESTとストリーミングのSTT料金(参照日: 2026-09-20)。
- AA-WER Streamingの結果報告 — Artificial Analysis、公開埋め込み用データで取得できた本文を参照。長文の省略部分は未確認(参照日: 2026-09-20)。
- Speech to Text Streaming Benchmark — Artificial Analysis、評価データと測定方法。動的なランキング表の全行は未取得(参照日: 2026-09-20)。
- LoomからCursorへつなぐ活用例 — SpaceXAI、公式Xの公開埋め込み用データで本文を確認(参照日: 2026-09-20)。