Qwen3.8-Omni-Flash|音声・動画分析で変わる3点
代表取締役 上坂大地郎
録音や動画の内容を読み取り、文章で要点や作業案を返す新モデル「Qwen3.8-Omni-Flash」が登場しました。音声・映像の理解とツール呼び出しを組み合わせる設計で、APIの出力はテキストです。 音声を入力できることと、音声で話しかけてくれることは分けて捉える必要があります。公式モデル仕様。
今回押さえたい変更と条件は、次の3点です。
- 入力はテキスト・画像・音声・動画。 最大100万トークンのコンテキストに対応します。
- 内容の分析からツール連携へ。 Function CallingやWeb検索に対応しますが、動画編集などの成果物を作るには周辺ツールも必要です。
- 利用地域と出力形式を選んで試す。 東京を含む提供リージョンが案内されています。料金は地域別に確認し、音声出力が必要なら別モデルも検討します。
録画から手順書を作りたい人、会議音声を分析する仕組みを作る開発者、動画を扱うAIの違いを知りたい担当者に向けた記事です。新モデルで何を試すか、既存の音声会話モデルとどこを分けるかを整理できます。確認日は2026年9月19日。APIの実行や日本語精度の独自測定は行っておらず、仕様は公式資料、試し方は編集上の提案として記載します。
新しいOmniは、音声・映像を扱う作業向け
9月18日の発表と、サービス側の掲載日を分ける
Qwen公式は9月18日、音声・映像の理解、推論、ツール利用を組み合わせるモデルとしてQwen3.8-Omni-Flashを紹介しました。公式Xの発表とQwenCloudのモデル更新履歴で確認できます。一方、Alibaba Cloudの新モデル一覧には9月17日付の掲載があります。ここでは公式発表は9月18日、サービス側の掲載日は9月17日と区別し、全リージョンが同じ時刻に開放されたとは扱いません。モデル更新履歴、新モデル一覧。
「Omni」は、文章だけでなく音や映像も扱うモデル系列を指します。今回のモデルIDはqwen3.8-omni-flashです。名前が似ているQwen3.8-FlashやQwen3.5-Omniの設定例を、そのまま当てはめないようにしてください。特に出力できる形式は、モデル名ごとに確認が必要です。
「映像を見て説明する」から、後続の作業へつなぐ
公式の更新履歴は、動画の編集、映像の説明、マルチメディアの要約などを想定用途に挙げています。注目点は、音や映像から読み取った内容を、その後の作業に使う設計です。たとえば、動画を見て説明文を返すだけでなく、必要な場面を探し、編集用の処理へ渡す構成が考えられます。QwenCloudの発表。
ただし、この説明は提供元が示す用途です。録画を渡せば完成動画や正確な手順書が自動で得られる、と確認されたわけではありません。どの道具につなぐか、結果をどう点検するかは、利用するアプリや開発側の構成に依存します。最初に試すなら、完成品を一括で作らせるより、素材の読み取りが合っているかを確かめるところから始めるのがよいでしょう。
入力できる4種類と、返ってくるもの
音声を送っても、応答は文章
Alibaba Cloudの現行モデル仕様では、入力はテキスト・画像・音声・動画、出力はテキストです。利用するAPI形式はChat CompletionsまたはResponses。音声入力を文章へ変換する処理や、映像の内容に関する質問は対象ですが、音声合成まで同じモデルの機能として期待しないでください。入出力とAPIの仕様。
公式のOmni案内も、文章による分析にはQwen3.8-Omni-Flash、音声出力にはQwen3.5-Omniを案内しています。番号が新しいかだけで選ぶと、欲しい応答形式から外れる場合があります。電話や音声アシスタントを作る人は、録音を後から分析する処理と、その場で音声を返す処理を別々に設計すると整理しやすくなります。Omniのモデル選択。
やりたいこと | 今回のモデルで確認する点 |
|---|---|
録音を読んで要点を文章にする | 音声入力と、固有名詞・決定事項の認識精度 |
操作動画から説明文を作る | 画面と発話の対応、手順の抜け |
分析結果から別の処理を呼ぶ | ツールの定義、実行結果、失敗時の扱い |
音声で返事をするアプリを作る | 今回のAPI出力はテキスト。音声出力用の構成を別途選ぶ |
録音分析と音声会話の違いは、GPT-Live-1のAPIと音声設計でも扱っています。モデル同士の精度順位ではなく、必要な出力から選ぶための関連記事です。
100万トークンは、動画の長さを保証する数字ではない
コンテキストとは、一度の処理で参照する情報を置く作業机のようなものです。最大100万トークンという容量があっても、100万文字を入れられるという意味ではありません。文字、画像、音声、映像は、それぞれの方法で処理用の単位に換算されます。モデルの容量。
動画なら、長さだけでなく取り出すフレームや解像度が関わります。公式の利用案内には、音声・画像・映像ごとのトークン換算と制約が別に記載されています。「長時間の動画でも入るはず」とまとめて送る前に、扱う形式とサイズを確認してください。入力とトークンの扱い。
また、入力が受け付けられたことと、必要な場面を正しく見つけられたことは別です。長い会議から決定事項を拾わせる場合も、議題が変わった位置、後で撤回された発言、画面だけに出た条件が残っているかを人が照合します。
入出力と作業のつながりを、次のように整理できます。
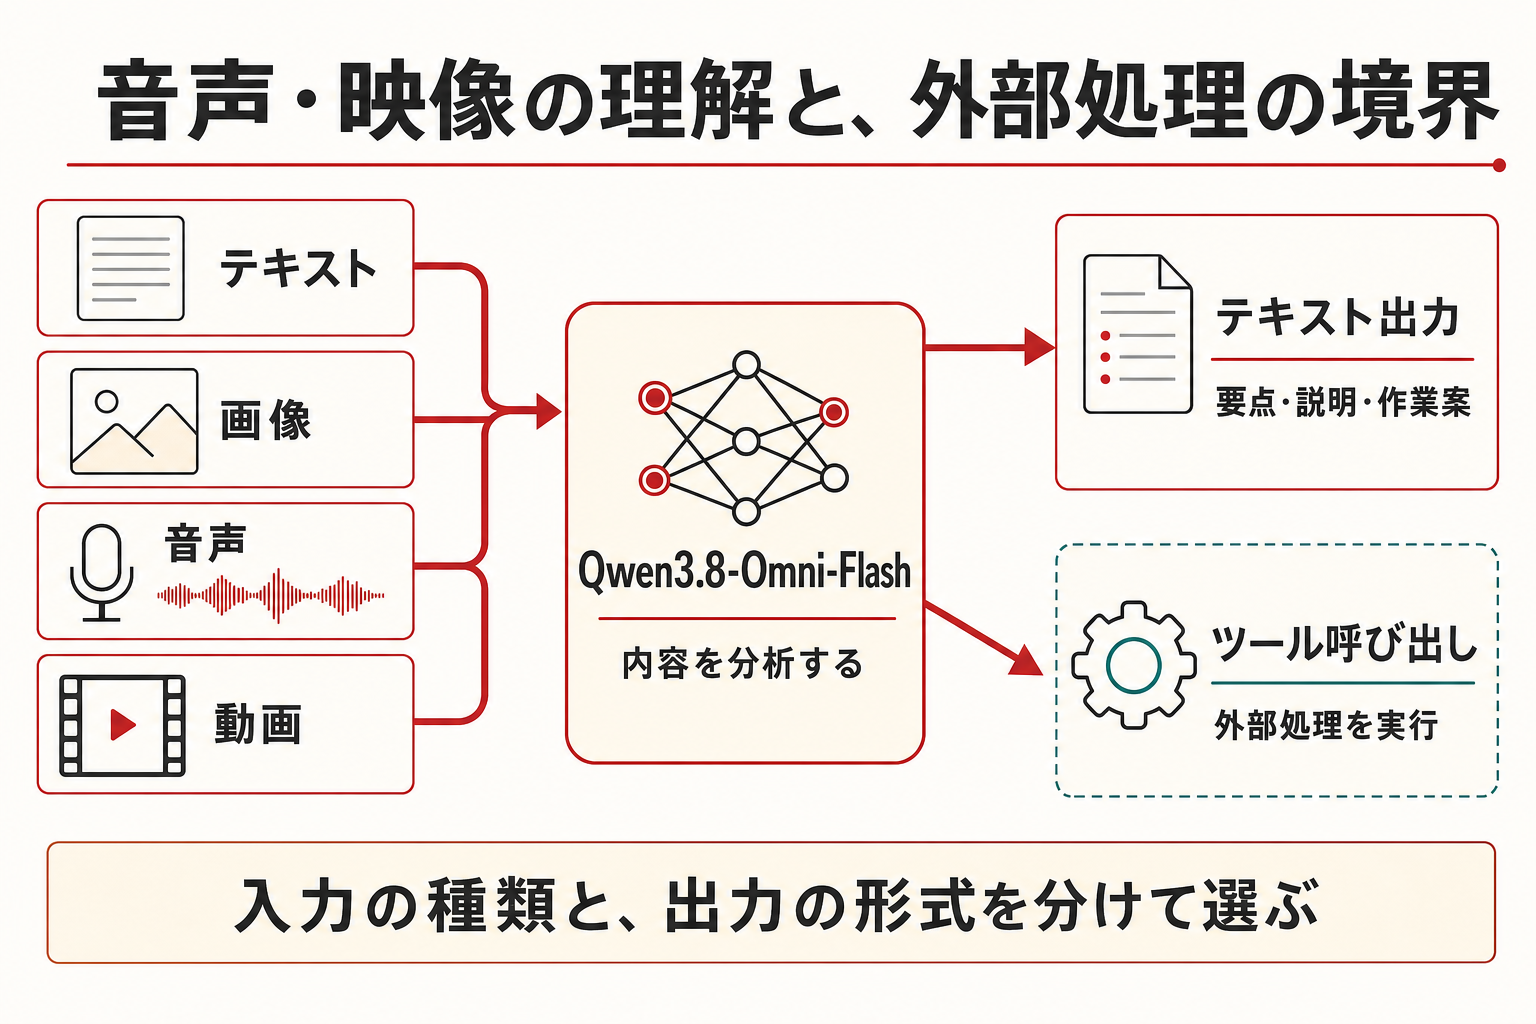
入力の種類、モデルの応答、外部ツールの仕事を分けて読むと、音声・映像を扱えるという説明から、必要なアプリ構成まで判断しやすくなります。
ツールと組み合わせると、動画から何を作れるか
Function Callingは「実行した」の証明ではない
Function Callingは、モデルが使いたい道具と引数を返す仕組みです。担当者が作業依頼書を書く場面をイメージすると近いでしょう。依頼書ができても、依頼先で作業が終わったとは限りません。開発側は、ツール呼び出しを実行し、その結果を確かめる処理を用意します。
Qwen3.8-Omni-Flashはカスタムツール呼び出しに対応します。また、現行英語資料ではWeb検索にも対応し、Responsesの組み込み検索ツール名はweb_searchです。Web検索と、任意の社内システムを操作する権限は同じものではありません。 接続先ごとの設定が必要です。対応機能。
ツール連携を試す際は、「モデルが呼び出しを要求した」「アプリが実行した」「結果を受け取った」を分けて記録します。失敗した処理を成功として文章にまとめていないかを確認するためです。公式のFunction Calling案内も、モデルの指示を受けたアプリがツールを実行し、その出力をモデルへ返す流れを示しています。モデルに任せる範囲と、アプリ側で処理する範囲を先に決めてください。ツール呼び出しの流れ。
公式プラグインには、録画を資料へ変える例がある
Qwenの公式リポジトリ「Qwen-MM-Plugins」には、チュートリアル動画を図入りPDFへ変えるomni-video2noteや、動画制作を支援するomni-chatcutが掲載されています。前者にはDashScopeのAPIキーとffmpeg、後者には用途に応じた生成サービスや動画処理の道具などが必要です。公式プラグイン。
この構成から分かるのは、モデルによる理解と、成果物を組み立てる処理を組み合わせて使うということです。モデル単体のテキスト出力と、プラグイン経由で作るPDFや動画を混同しないでください。プラグインを利用する場合も、何を外部サービスへ送り、何を手元で処理するかを確認します。
想定シナリオとして、操作説明の録画から社内向けの手順書案を作る仕事が考えられます。画面内の操作と説明音声を対応させ、手順の見出しを起こし、人が抜けを直す流れです。まず欲しいのは見栄えのよいPDFより、「説明されていない操作を作っていないか」を点検できる原稿です。完成物だけを見るより、元の動画と照合する位置を残しておくと修正しやすくなります。
東京を含む提供地域と、料金表の読み方
リージョンの名前だけで、データの扱いを決めない
公式モデル仕様は、北京、シンガポール、香港、東京、フランクフルト、バージニアを対応リージョンとして挙げ、選んだ地域のAPIキーを使うよう案内しています。東京の提供が記載されていることは確認できましたが、個別アカウントの有効化や接続成功は本記事では検証していません。提供リージョン。
料金表では、東京の行にあるDeployment scopeはGlobalです。「東京を選べる」という情報だけで、あらゆる処理や保存が日本国内で完結すると判断しないでください。顧客の会議や社内録画を使う場合は、利用契約とデータの取り扱いを確認したうえで素材を選びます。
入力・キャッシュ・出力の単価を分ける
9月19日に確認した公式料金表は、次の単価を掲載しています。いずれも100万トークンあたりの米ドル価格です。動画1本や音声1分の定額料金ではありません。地域別料金表。
リージョン/提供範囲 | 通常入力 | キャッシュ命中時の入力 | 出力 |
|---|---|---|---|
東京/Global | $0.113 | $0.014 | $0.382 |
シンガポール/International | $0.15 | $0.016 | $0.47 |
キャッシュは、以前の計算結果を再利用する仕組みです。安い単価を見積もり全体へ当てはめず、再利用された入力と通常入力を分けます。外部の検索・生成サービスも組み合わせるなら、その料金も別に見ます。
最初の比較では、同じ素材、同じ質問、同じ出力条件を使い、応答の使用量と請求明細を残す方法を勧めます。短い答えで終えた場合と、細かな説明を何度も追加した場合を同じ費用として比較しないためです。単価の低さだけで採否を決めず、人が修正する時間も一緒に見てください。
最初の録画では「何を正解とするか」を先に決める
人が答えを知っている短い素材で照合する
ここからは、新モデルを評価するための提案です。公式の性能測定結果ではありません。最初は、内容を把握している短い録画を使い、画面にしか出ない情報と、音声にしか出ない情報をそれぞれ用意します。機密情報を含まない自作素材なら、誤りを確認しやすくなります。
たとえば操作説明なら、ボタン名は画面に表示し、その操作を行う理由は口頭だけで説明します。どちらか片方だけを拾った回答でも、文章として自然に見える場合があるためです。回答を読む前に、人が確認した操作順と注意点をメモしておくと、もっともらしい要約に引っ張られずに比較できます。
公式の開始例は、APIキーを設定し、利用するワークスペースの接続先を選び、アクセス可能な音声URLを指定してリクエストする流れです。最初のAPI接続はその例に沿い、動作を確認してから動画やツール連携へ広げてください。公式の開始例。
観察した事実と、提案を分けて返してもらう
次は、動画を分析する際の指示文案です。指定どおりの形式や正確な時刻が返ることを保証するものではなく、人が確認するための出力の形を揃える目的で使います。
添付した操作説明の動画を読み、手順書の下書きを作ってください。画面で確認した内容と、音声で説明された内容を分けてください。各手順に、根拠となる場面の時刻を付けてください。時刻や文字を読み取れない場合は「確認できない」と書いてください。説明されていない操作は補わず、追加確認が必要な点にまとめてください。最後に、動画から分かった事実と、改善の提案を分けてください。点検するのは、操作の順番、固有名詞、根拠の時刻、推測の混入です。時刻が付いていても正しいとは限らないため、元の動画を開いて確かめます。映像から読み取れない部分を一般的な操作で埋めた回答は、手順書としてそのまま採用しないでください。
この確認を終えてから、資料化や動画編集の道具をつなぎます。読み取り段階に誤りがあるまま成果物の自動生成まで進めると、間違った操作が整った資料として残るおそれがあります。分析結果のどこを直したかが追える状態で、次の処理へ渡します。
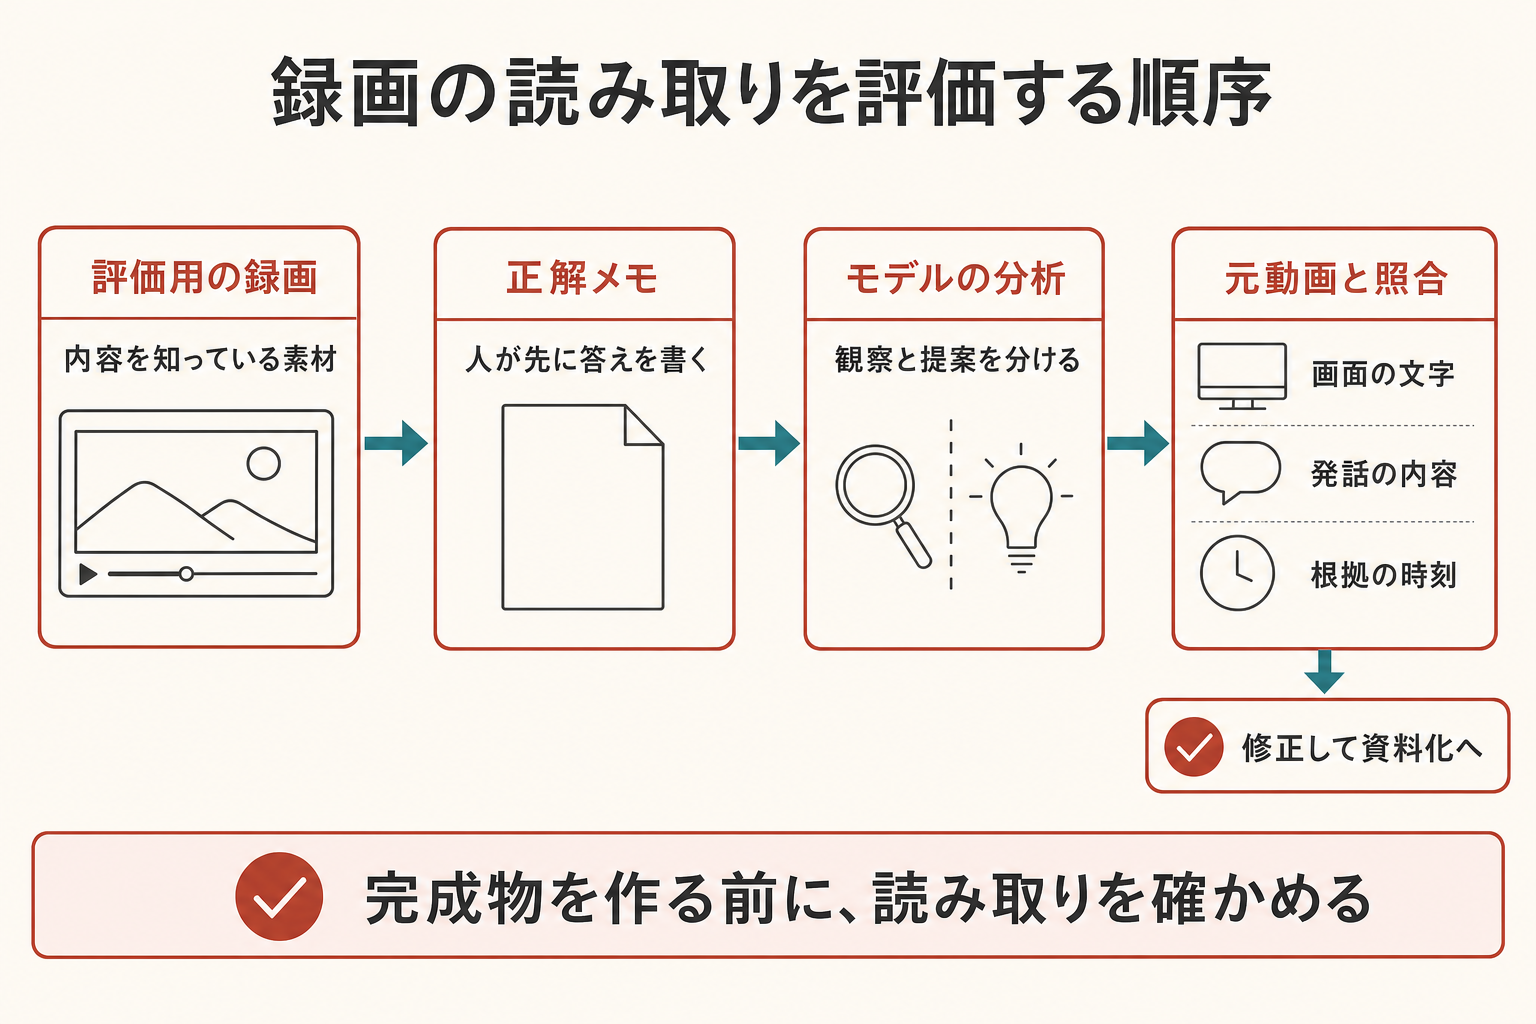
見栄えの整った資料だけで評価せず、素材の読み取りを先に確かめます。録画と回答を対応させて残すと、モデルや設定を変えたときも同じ条件で比べられます。
試す仕事は、必要な出力から選ぶ
Qwen3.8-Omni-Flashは、音声や映像を読んで文章として整理し、必要に応じてツールへつなぐ用途で検討できる新モデルです。最初の候補には、操作動画からの手順書案や、録音からの要点抽出が挙がります。音声で返答させたい場合は、音声出力を持つモデルや構成を選び直します。
まずは自分が内容を知っている素材を1本選び、期待する答えを先に書き、モデルの出力と照合してください。試した結果がよければ、次は素材を増やし、修正の手間と費用がどの程度変わるかを見ます。提供元の機能一覧は試す入口になり、採用を決める材料は手元の仕事で得た結果になります。
録音から文字を起こす処理を先に検討するなら、OpenAIの文字起こしAPIも参照してください。会話・文字起こし・音声映像の分析のうち、どの処理を作りたいかを切り分けると、比較する対象を絞れます。
参考・出典
- Qwen公式の新モデル発表 — Qwen(公開埋め込みで発表本文の一部・投稿日時を確認、参照日: 2026-09-19)
- Model releases — QwenCloud(参照日: 2026-09-19)
- Newly released models — Alibaba Cloud(参照日: 2026-09-19)
- qwen3.8-omni-flash Model Info — Alibaba Cloud(参照日: 2026-09-19)
- Qwen-Omni 利用案内 — Alibaba Cloud(参照日: 2026-09-19)
- Function calling — Alibaba Cloud(参照日: 2026-09-19)
- Qwen-MM-Plugins — QwenLM(参照日: 2026-09-19)
- Model pricing — Alibaba Cloud(参照日: 2026-09-19)