DeepSeek V4.1 Flash公開|画像対応と料金・移行の注意点
代表取締役 上坂大地郎
DeepSeekのAPIで、画像と文章を一緒に扱う新モデル「V4.1 Flash」を使えるようになりました。既存のFlash利用者は、設定を変えていなくても接続先のモデルが更新されています。 2026年9月10日の発表から、モデルの構造、料金、旧モデルの扱いを分けて押さえる必要があります。公式発表。
今回の確認点は3つです。
- 新規に呼び出すモデル名は
deepseek-flash。 旧Flashのモデル名も受け付けますが、中身はV4.1 Flashです。 - 画像理解と、入力・出力で計算量を変える設計が特徴です。 ベンチマークの向上は提供元の評価であり、手元の仕事でも同じ改善が出るとは限りません。
- V4 Proは継続提供の案内へ変わっています。 発表時の「9月14日にFlashへ転送する」という予定を、現在の確定事項として扱わないでください。
APIで文章処理やコーディング支援を作っている開発者、スクリーンショットの読解を組み込みたい担当者に向けた記事です。読み終えたら、使っているモデル名と請求条件を照合し、新モデルで試す仕事を選べます。仕様の確認日は2026年9月12日。APIの実行速度や日本語の認識精度を独自に測った記事ではありません。現行のAPI案内、料金表。
旧Flashは更新済み、V4 Proは継続へ訂正
設定名が同じでも、以前のモデルとは限らない
DeepSeekのAPI資料では、deepseek-flashがV4.1 Flashに対応します。deepseek-v4-flashとdeepseek-v4-flash-vision-expは互換性のため残る名前で、対応する旧モデル自体は退役し、リクエストは新Flashで処理されます。APIのモデル名と互換性。
指定するモデル名 | 9月12日に確認した扱い | 利用者が確認すること |
|---|---|---|
| V4.1 Flashを呼び出す現行名 | 新規設定ではこの名前を使う |
| V4.1 Flashへ転送 | 以前の応答との違いを再評価する |
| V4.1 Flashへ転送 | 画像入力と出力形式を再確認する |
| V4 ProのAPI提供・課金方式を継続 | 終了予定の古い案内と区別する |
「昨日まで同じ設定で動いていた」という理由だけでは、生成内容が変わらないことの確認にはなりません。出力を後続のプログラムで読む場合は、JSONの項目、文章の長さ、ツールへ渡す引数なども比べてください。これはモデル更新を受けた利用者側の確認案です。
9月14日の切り替え予定を、そのまま転記しない
9月10日の発表ページには、9月14日04:00 UTCからV4 ProへのリクエストをV4.1 Flashへ転送する案内が残っています。日本時間では同日13時です。一方、執筆時点のAPIトップ、料金表、更新履歴は、利用者の要望を受けて9月14日以降もV4 ProのAPIサービスを継続し、課金方式も維持すると説明しています。発表時の記述、訂正を含む更新履歴。
現在の運用判断には、継続の案内を使います。ただし、終了が永久に取り消されたという意味ではありません。将来変更があれば改めて通知するという説明で、新しい終了日は今回の確認範囲にはありません。V4 Proを使っている人は、急いで設定を書き換える前に現行資料を確認するのが先です。
名前と実際の接続先を、次の分岐で整理できます。
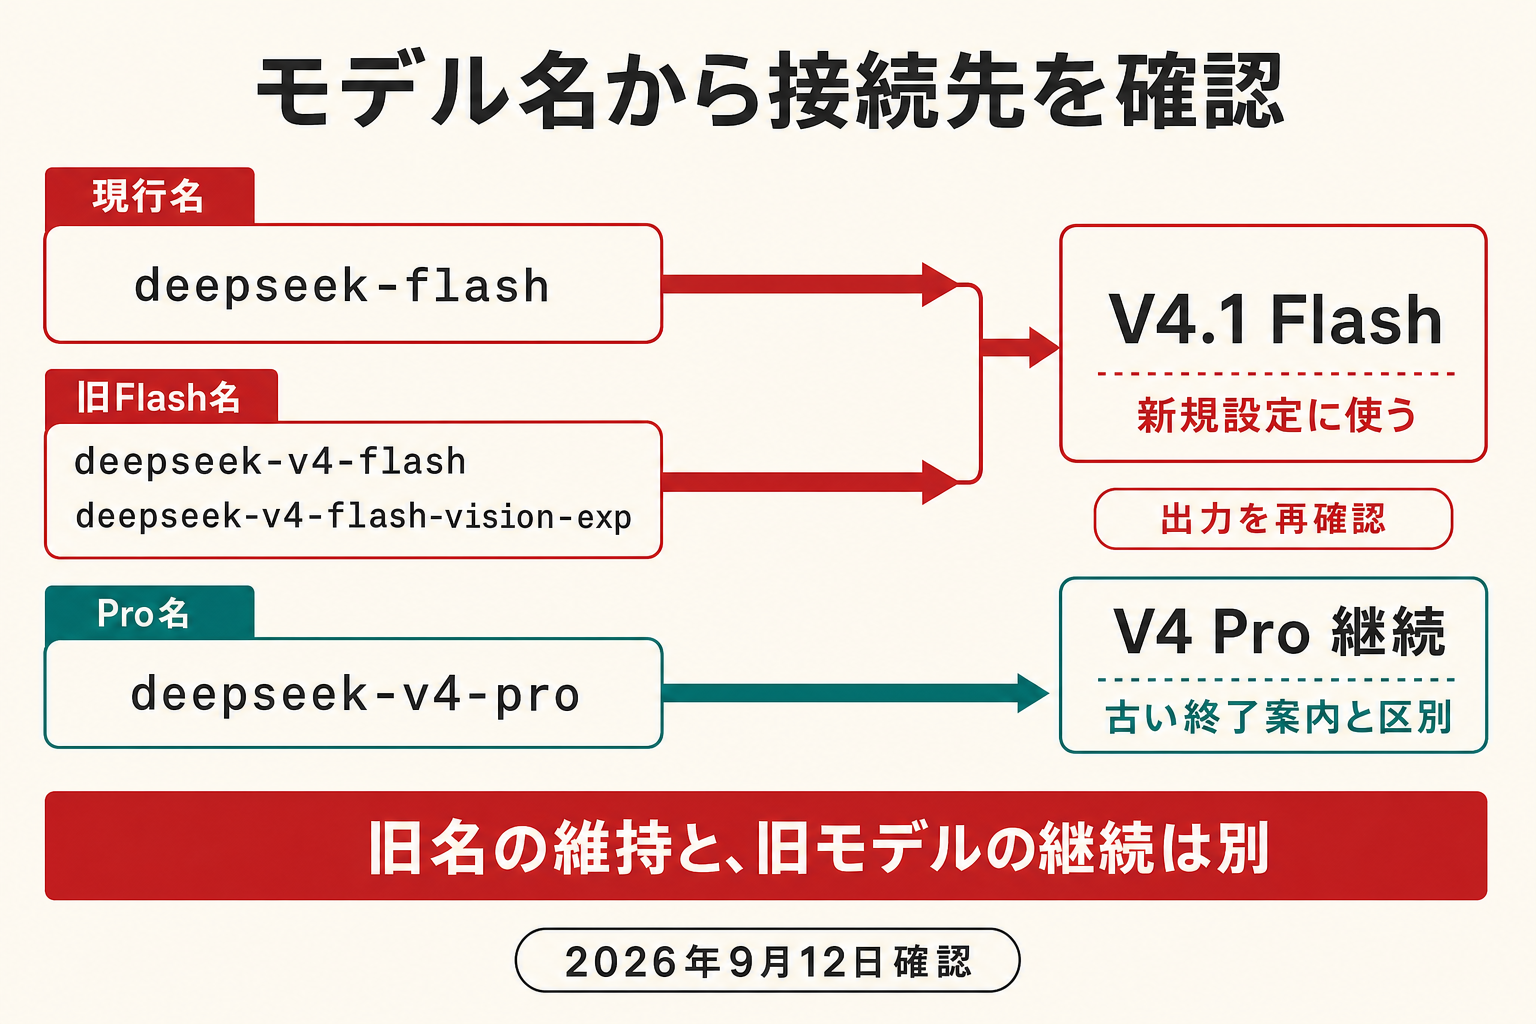
モデル名を残した互換対応と、旧モデル自体の継続は別です。設定を変更していない処理でも、保存済みの出力例と比較してください。
入力を読む処理と、答えを書く処理を分けた設計
「8Bで動く」をモデル全体のサイズと混同しない
公式モデルカードは、V4.1 Flashの基盤部分を552BパラメータのMoEと説明しています。Bは10億を表すため、552Bは5,520億です。MoEは、処理ごとに一部の専門部品を選んで使う方式です。大きな組織の全員が毎回同じ仕事をするのではなく、必要な担当が動くと考えると近いでしょう。公式モデルカード。
新しいCausal Encoder–Decoderという構造では、入力を読む段階で8B、出力を生成する段階で16Bのパラメータが動くと説明されています。この数値は、その段階で使う部分の規模です。モデル全体が8Bになったわけでも、8Bモデルと同じ機器で動くと確認されたわけでもありません。
長い資料を読み、何度もツールを呼ぶ仕事では、毎回どれだけの入力を処理するかが費用に効きます。入力側の計算や保存する情報を小さくする設計は、そうした用途に向けたものです。もっとも、構造の効率と、利用者が体感する応答速度は同じ指標ではありません。
キャッシュの省メモリ化と請求額は分けて読む
DeepSeekは、前世代に比べてKVキャッシュが必要とするHBMを4分の1、SSD容量を8分の1に抑えると発表しています。KVキャッシュは、すでに読んだ内容の計算結果を再利用するための保存領域です。HBMは高速なメモリ、SSDは保存装置を指します。構造とキャッシュの発表。
この説明を「自分のAPI代が一律8分の1になる」と読み替えることはできません。請求額は入力・出力の量、キャッシュが使われた量、利用時間帯で決まります。モデル内部の改善は背景として理解し、実際の支出は料金表と応答の使用量で計算します。
画像から何を読ませられるのか
V4.1 Flashは画像とテキストを入力し、テキストを返すモデルです。画像を作るモデルではありません。公式Vision資料は、写真の説明、スクリーンショット中の文字の読解、グラフの分析などを例に挙げています。Visionの仕様。
想定シナリオとしては、エラー画面からメッセージを取り出し、関連するログと照合する処理が考えられます。画像だけで原因を決めさせず、「画面に見える事実」と「追加で確認すること」を分けて返させると、人が確認しやすくなります。
画像の受け渡しは3つの方法から選ぶ
画像はBase64でリクエストへ埋め込む、公開URLを渡す、Files APIでアップロードしたファイルIDを参照する方法に対応しています。手元の画像を一度試すなら埋め込み、同じ画像を繰り返し参照するならファイルIDの利用が候補です。公開URL方式ではサービス側から画像を取得できる必要があります。
対応形式はJPEG・PNG・GIF・WebPです。Chat Completions形式では画像をuserメッセージに置き、systemやassistantへ入れると400エラーになると案内されています。API形式ごとの制約があるため、別の形式のサンプルを混ぜないでください。画像の送信方法と制約。
読解できることと、業務上必要な精度が出ることも別です。数字、否定表現、小さな注記が判断を変える画像を選び、元画像と突き合わせる検査を用意します。機密情報を送る場合は、使用するAPI提供者との契約・データの扱いを先に確認してください。本記事では、その契約条件の適否までは判定しません。
料金は時間帯とキャッシュの2条件で変わる
100万トークン単位の公式料金
9月12日時点のDeepSeek直提供APIの料金は次のとおりです。単位は米ドル/100万トークンで、トークンは日本語の文字数と一致しません。仲介サービスの料金表へ、この単価をそのまま当てはめることはできません。Models & Pricing。
V4.1 Flashの課金対象 | ピーク時間 | オフピーク時間 |
|---|---|---|
入力・キャッシュヒット | $0.006 | $0.003 |
入力・キャッシュミス | $0.30 | $0.15 |
出力 | $1.20 | $0.60 |
公式のピーク時間は月〜金の01:00〜04:00 UTCと06:00〜10:00 UTCです。日本時間では月〜金の10〜13時と15〜19時で、それ以外はオフピークです。締め切りに余裕がある処理は時間帯を選べますが、待たせることで仕事が止まるなら、単価だけでは判断できません。
「入力料金$0.003」だけでは見積もれない
最も低い料金は、オフピークかつキャッシュが使われた入力の単価です。初めて送る内容やキャッシュに一致しない部分、生成した出力まで同じ料金になるわけではありません。
想定計算として、キャッシュミスの入力を100万トークン、出力を10万トークン使った場合、ピークでは0.30+0.1×1.20=0.42ドル、オフピークでは0.15+0.1×0.60=0.21ドルです。これはそのトークン量を前提とする計算例で、1件の仕事の実測費用ではありません。
請求の考え方は、入力をキャッシュの有無で分け、出力を別に足す形です。
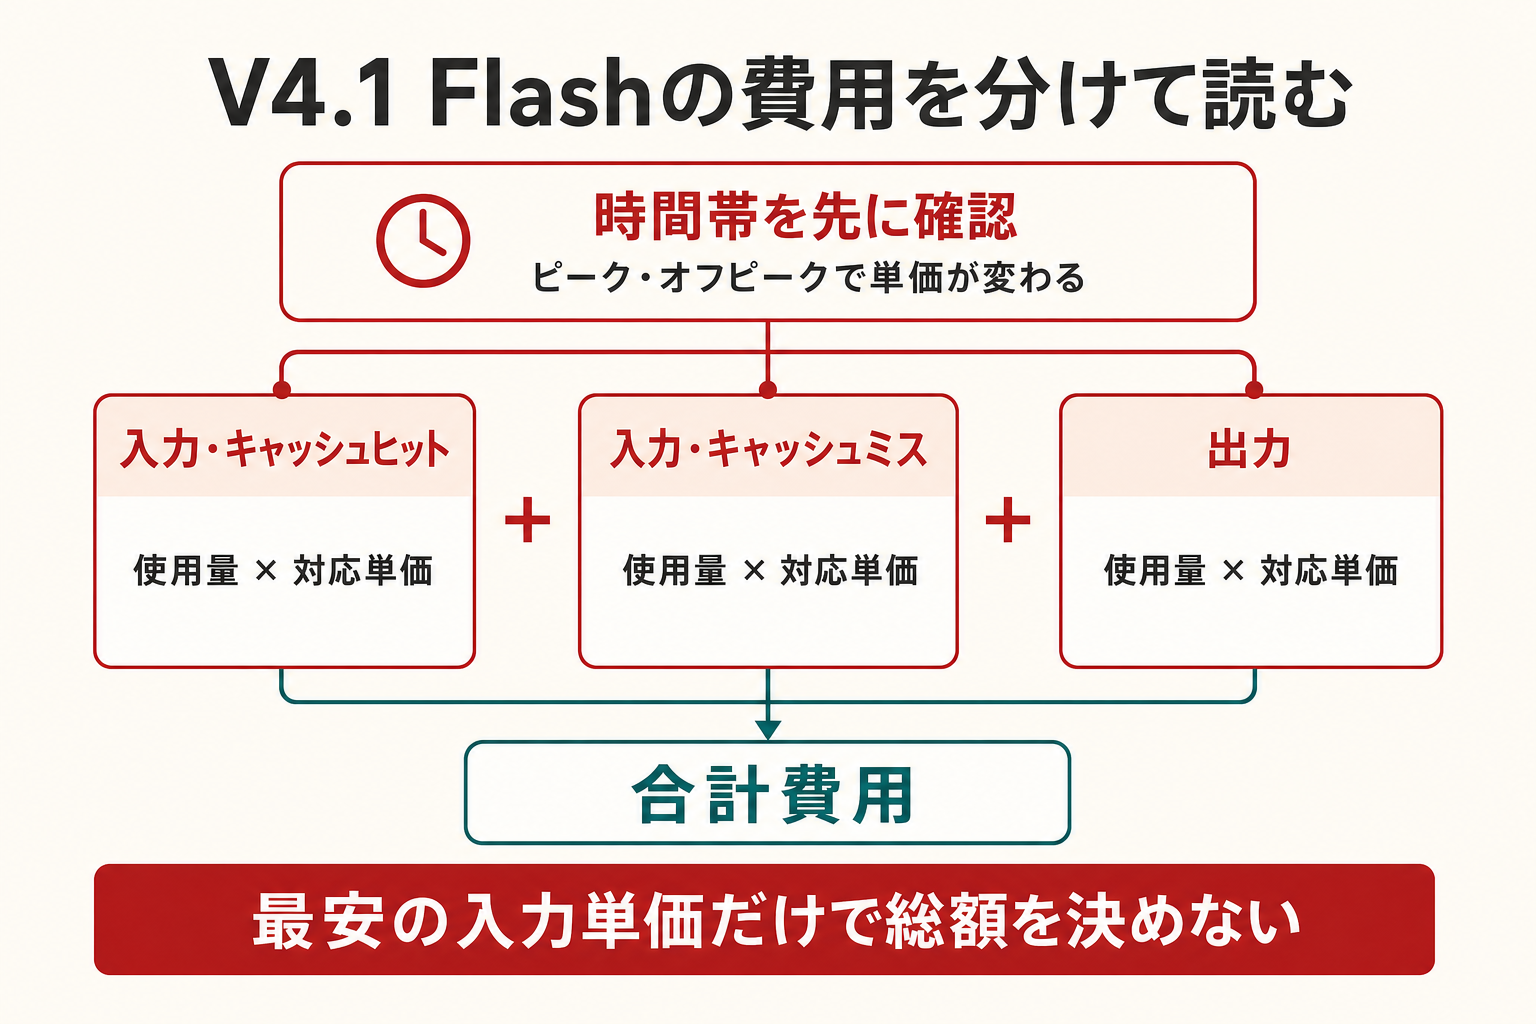
キャッシュが効いた入力と初回の入力、生成した出力を分けると、最低単価の印象に引っ張られず、実際の処理量から費用を見積もれます。
キャッシュは、同じ資料を送れば毎回使えるとは限らない
公式資料によると、キャッシュは既定で有効ですが、保存された入力の先頭部分との一致などが条件になります。応答のusageにあるprompt_cache_hit_tokensとprompt_cache_miss_tokensで、実際に使われた量を確認できます。キャッシュ作成には時間がかかり、ヒットも保証されません。Context Caching。
固定の説明や資料を入力の前方へまとめる設計を試す場合も、効いたはずと推定せず使用量を残します。リトライや追加質問が増えれば、その分も仕事の費用です。API費用を減らす観点はClaude APIコスト最適化の記事にも整理していますが、具体的な単価とキャッシュ条件はサービスごとに確認してください。
ベンチマークの「勝ち」を仕事へ持ち込む前に
公式モデルカードの評価では、V4.1 FlashはDeepSWE v1.1で74.2、V4 Proは62.7と報告されています。一方、GPQA DiamondではV4.1 Flashが90.9、V4 Proが92.4です。同じ提供元の表でも、すべての評価項目で新Flashが上回るわけではありません。 評価表と測定条件。
DeepSWEはソフトウェア課題の解決、GPQAは難しい知識・推論問題をみる評価です。違う能力を測る数値を合算して、唯一の順位にする必要はありません。自分の用途がコード修正なのか、根拠を伴う専門的な回答なのかで、見る箇所が変わります。
公式の指示調整済みモデルの評価は最大の推論設定を使い、エージェント評価には実行用の仕組みやコンテキスト長の条件があります。手元のツールで標準設定のまま使った結果と同一ではありません。速度向上の説明も提供元の主張として読み、日本語の出力品質、待ち時間、やり直し回数は別途確認します。
最初の確認は、モデル名と小さな入力から
接続テスト用のPython例
以下は公式の初回API例とThinking Mode資料に沿って、短い日本語入力へ置き換えたものです。独自のAPI実行はしていません。DeepSeekのAPIキーを環境変数DEEPSEEK_API_KEYへ設定し、OpenAI形式に対応したSDKを用意して実行します。接続先はDeepSeekです。初回API例、推論設定。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": "次のメモを、事実と未確認事項に分けてください。"
                   "メモ: テストは成功。公開環境での動作は未確認。",
    }],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)
print(response.choices[0].message.content)
print(response.usage)
合格条件は、テスト成功と公開環境の未確認を混ぜないことです。「テストが成功したので公開環境でも動く」と補ったら、接続には成功していても内容の検査では不合格にします。短い入力から始めれば、通信の問題と出力の問題を切り分けやすくなります。
互換APIでも、設定の効き方は確認する
推論モードでは、temperatureなど一部の設定は指定しても無効と説明されています。また、ツールを使う複数ターンの会話ではreasoning_contentの受け渡しに条件があります。OpenAI形式に対応しているという理由だけで、以前の設定一式が同じ意味で動くとは判断しないでください。Thinking Mode。
遅い場合も、モデルの能力だけを原因にしないことです。公式資料では同時接続数の上限はアカウント単位で管理され、上限超過は429エラーになります。待機中の空行やストリーミングのkeep-aliveを、応答本文と誤認しない実装も必要です。Rate Limit & Isolation。
切り替えを決めるために残す記録
試す仕事は、正解条件がある小さなものを選びます。以下は比較のための編集上の提案です。前モデルの記録がなければ、旧Flash名を呼んで比較する方法は使えません。旧名もV4.1 Flashへ転送されるためです。
試す仕事 | 用意する入力 | 合否を決める項目 |
|---|---|---|
文章の整理 | 事実と未確定が混ざった短いメモ | 未確定を確定へ書き換えない |
画像の読解 | 数字や注記が読める検証用スクリーンショット | 数字・否定・小さな文字を元画像と照合できる |
コード修正 | 小さな不具合と既存のテスト | 修正理由が説明され、テストが通る |
入力と推論設定を保存し、所要時間、合否、追加のやり直し、API使用量を同じ記録へ残します。コードの見た目が自然でも、既存処理を壊していないかは別の検査が必要です。AI生成コードの人間レビュー5観点を確認項目に加えられます。
旧Flashを使っている人は、まず現在の出力を取り直す。V4 Proの利用者は、継続の案内を確かめてから比較する。初めて使う人は、画像理解が必要な仕事か、長い入力を繰り返す仕事かを決めて、小さな試作へ進む。この順なら、発表時の終了予定や最安単価だけを見て切り替えることを避けられます。
参考・出典
- Introducing DeepSeek-V4.1-Flash — DeepSeek(参照日: 2026-09-12)。発表時のV4 Pro転送予定が残るため、現行API資料と区別。
- Your First API Call — DeepSeek API Docs(参照日: 2026-09-12)。モデル名、旧Flashの転送、V4 Pro継続の案内。
- Change Log — DeepSeek API Docs(参照日: 2026-09-12)。9月10日発表と継続提供への訂正。
- DeepSeek-V4.1-Flash Model Card — DeepSeek-AI(参照日: 2026-09-12)。構造と提供元による評価条件・結果。
- Vision — DeepSeek API Docs(参照日: 2026-09-12)。画像入力形式と制約。
- Models & Pricing — DeepSeek API Docs(参照日: 2026-09-12)。直提供APIの単価と時間帯。
- Context Caching — DeepSeek API Docs(参照日: 2026-09-12)。キャッシュの成立条件と使用量。
- Thinking Mode — DeepSeek API Docs(参照日: 2026-09-12)。推論設定と互換APIの注意。
- Rate Limit & Isolation — DeepSeek API Docs(参照日: 2026-09-12)。接続数と待機中の応答。