Gemini 3.8 TTSで声を作る|新2モデルの表現・料金・移行点
代表取締役 上坂大地郎
説明動画や読み上げの音声を作るなら、Gemini 3.8 Flash TTSとFlash-Lite TTSが新しい選択肢になります。声の特徴を設計し、せりふごとの話し方を指定するモデルです。 Googleの発表記事は2026年9月23日付。APIのリリース履歴では、9月22日に一般提供(GA)と記録されています。この記事は9月25日に確認した公式資料に基づきます。公式発表、API更新履歴。
- Flashは声の表現、Flash-Liteは大量の音声生成を重視する位置づけです。実際の日本語品質は、自分の台本で確かめる必要があります。
- 声の設計と、各せりふの演技指定を分けて管理できます。既存の人の声を複製する場合は、本人の同意確認が条件です。
- 料金には適用期限があり、旧TTSからは入力形式と音声の保存処理も変わります。 モデル名の変更だけで移行を終えないようにしてください。
動画にナレーションを付けたい人、サービスの読み上げ機能を作る人、既存のGemini TTSを使う開発者に向けて、今回の差分を整理します。読み終えたら、試すモデルと、原稿・料金・コードのどこを確認するかを決められます。以下は公式仕様の解説と試用方法の提案で、音声品質を実測したレビューではありません。
TTSの新モデルは、会話用のGemini Liveと役割が違う
書いた原稿を音にするためのモデル
TTSはText-to-Speech、文字から音声を作る処理です。Gemini APIのTTSは文字を入力し、音声を出力します。原稿を決めたうえで、声や話す速さ、調子を調整する用途に向いています。TTS仕様。
たとえるなら、台本を渡して読み方を相談する収録です。一方、Gemini Liveは、その場で相手の発言などを受け取って返す会話が中心です。説明動画のせりふを読み上げたいのか、視聴者からの質問に応答したいのかで、最初に選ぶ機能が変わります。
双方向の音声会話を作りたい場合は、Gemini 3.8 LiveとExtended Thinkingの違いを先に確認すると整理しやすくなります。会話アプリの実装を検討中なら、GPT-Live-1の音声設計も比較対象です。TTSの更新を、会話モデル全体の更新として受け取る必要はありません。
APIのGAと、各製品への配信を分けて読む
今回のAPI用モデルIDは、gemini-3.8-flash-ttsとgemini-3.8-flash-lite-ttsです。API履歴は、この2モデルと音声を扱うVoicesエンドポイントのGAを記録しています。API更新履歴。
発表では、開発者向けの入口をGemini APIとGoogle AI Studioとしています。一般向けの提供先はFlashがGemini Notebook、Flash-LiteがGoogle Vids。Gemini Enterprise経由のAPI提供は、発表時点では今後の予定です。提供先の説明。
APIで一般提供と書かれていても、使っているアプリで全機能を選べるとは限りません。まず、自分が開いている製品と、そこで選べるモデルを確かめてください。日本の個別アカウントにどこまで表示されるかは、本稿では実機確認していません。
FlashとFlash-Liteは、完成させたい音声から選ぶ
表現を詰める収録と、繰り返す読み上げ
Googleのモデル資料は、Flashを演技の細かさや声の質感、長い音声の安定性を重視するモデルと説明しています。Flash-Liteは、読み上げ機能や大量の音声制作に向けた、速度と費用効率を重視する位置づけです。これは提供元の説明であり、どの原稿でも同じ差が出るという実測結果ではありません。Flashのモデル資料、Flash-Liteのモデル資料。
比べる項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
公式が重視する用途 | 演技、細かな発音、長いナレーション | 大量生成、日常的な読み上げ、音声エージェントの発話部分 |
最初に試す場面の提案 | 声の印象を詰めたい説明動画 | 多数の短い案内文を読み上げる機能 |
声の選択 | プリセット、設計した声、複製した声 | プリセット、設計した声、複製した声 |
3.8同士のAPI形式 | 共通 | 共通 |
Flash-Liteにも声の設計と複製が用意されています。 「自分で声を作るならFlashだけ」と分けるのは正確ではありません。両3.8モデルは同じAPI形式なので、比較の際は原稿や声の設定を揃えたまま、モデルを切り替えられます。Flash-Liteの対応機能。
安い方から試すか、表現重視で試すか
日々増える案内文なら、Flash-Liteが要求を満たすかを見るところから始めるのが一案です。固有名詞の発音や感情表現に修正が多ければ、同じ原稿をFlashでも生成して比べます。逆に、少数の動画に使う声の印象が主題なら、Flashで目標を探し、その後にLiteでも再現できるかを確認する順番が考えられます。
この順序は編集上の提案です。モデル名に含まれる「Lite」だけで採否を決めず、採用できる音声になったかを基準にしてください。音質に差を感じても、説明の分かりやすさが変わらない用途なら、費用や待ち時間を優先する余地があります。
声そのものの設計と、一文ごとの演技を分けられる
同じ声を呼び出し、せりふごとの調子を変える
Voice designでは、自然言語で声の特徴を指定してカスタム音声を作ります。作成した声のIDと試聴用音声を受け取り、後の音声生成ではそのIDを渡して使う仕組みです。Voice design。
たとえば、説明役を「落ち着いた、明るすぎない声」として設計し、注意事項を読む場面だけ話す調子を変える、という使い分けです。声の設計文に毎回のせりふを混ぜるより、誰が読むか、何を読むか、どう読むかを分けた方が、修正した条件を記録しやすくなります。
次の図は、この3つの指定が担う役割を整理したものです。
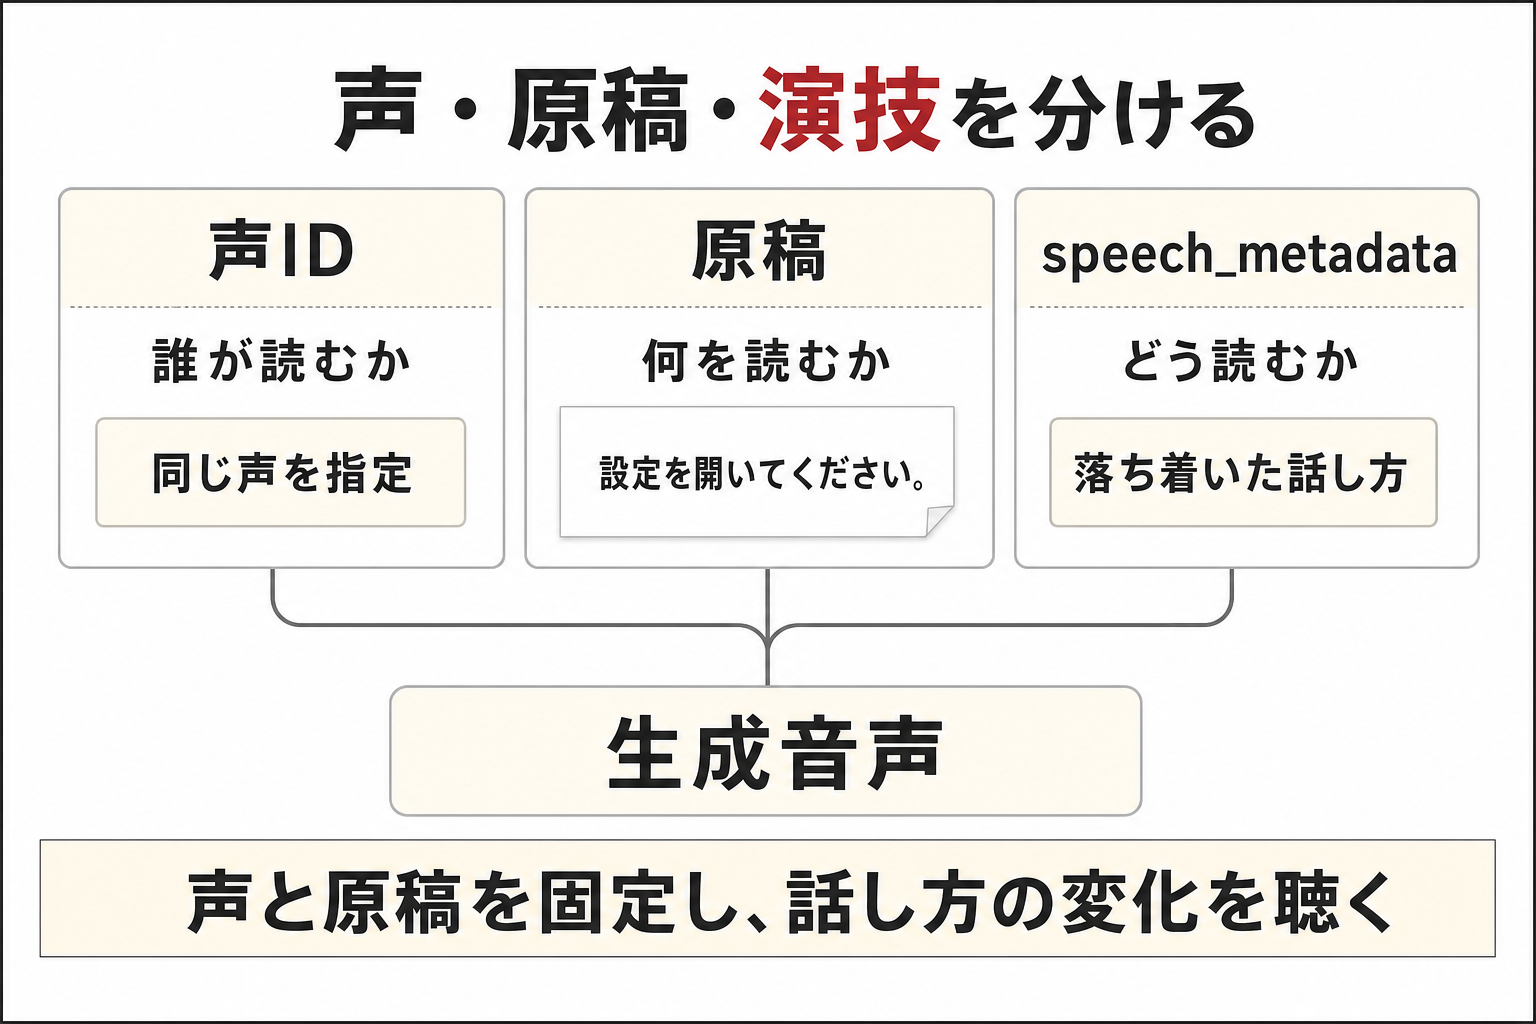
Gemini 3.8 TTSへの指定を、声ID、原稿、speech_metadataの3カードで整理。誰が読むか、何を読むか、どう読むかをそれぞれ指定し、3本の線が生成音声へ合流する。最下部は声と原稿を固定した試聴を勧める。
声と原稿を固定して話し方だけを変えると、試聴時に変更の影響を比べやすくなります。気になった箇所と指定を一緒に残してください。
APIでは、せりふ全体に続く演技の指定をspeech_metadataで扱います。本文には読ませたい内容、メタデータには話す調子を置くという区別です。これは、読み上げ原稿の脇に演出用のメモを添えるようなものです。演技指定と移行方法。
既存の声を使うときは、同意の録音も必要
Voice replicationのAPI資料では、同一の成人話者による参考音声と同意音声の2つを求めています。参考音声は10〜30秒の明瞭な発話で、同意音声には指定の文言を読み上げた録音が必要です。手元に短い録音があれば、その人の声を自由に複製してよい、という機能ではありません。Voice replicationの要件。
初めて試すなら、既存の人物を再現する必要があるかを先に考えてください。説明動画に合う声を探すだけなら、プリセットや新しく設計した声でも目的を満たせる可能性があります。本人の声を使う場合は、用途と音声素材を整理し、仕様に沿って同意確認を進めます。
なお、発表にはVoice remixingは今後提供予定とあります。声を新しく設計する機能と、既存ライブラリの声を後から細かく調整する予定機能は区別してください。機能の提供状況。
API料金は、年内と2027年以降を並べて見積もる
Standardの入出力単価
公式料金表のStandard料金は、次のとおりです。米ドル・100万トークン当たりで、入力はテキスト、出力は音声です。以下は音声制作にかかる全費用ではなく、APIの入出力単価を抜き出したものです。公式料金表。
課金対象 | 2026年12月31日まで | 2027年1月1日以降 |
|---|---|---|
Flash TTS・入力 | $0.50 | $1.00 |
Flash TTS・音声出力 | $9.00 | $18.00 |
Flash-Lite TTS・入力 | $0.50 | $1.00 |
Flash-Lite TTS・音声出力 | $6.00 | $12.00 |
価格表には無料枠も載っています。ただし、無料で利用できることを、件数や利用量に上限がないという意味には読み替えないでください。業務の予算では、有料枠の適用条件を確認したうえで、来年も使う分は翌年の単価で計算する方が、期限付き価格への依存を避けられます。
同じ料金表では、サービス改善へのデータ利用を無料枠はYes、有料枠はNoと示しています。未公開の原稿を入力する前に、使うプロジェクトの枠とデータの扱いを確認してください。無料枠と有料枠の区別は、金額だけの違いではありません。料金とデータ利用の区分。
原稿の量に、作り直した分を含める
試用時に残したいのは、最初の生成量だけではありません。発音を修正して再生成した分、話す調子を変えて比べた分も記録します。見積もりには「完成品の長さ」と「生成した総量」を別々に置くのが本稿の提案です。
たとえば、案内文の読み上げを何種類も試す想定シナリオでは、採用する音声は1つでも、APIに依頼した生成は複数回になります。出力単価の低さだけを見て、試行回数を同じと決めつけると、比較条件が揃いません。原稿を直す回数と、音声を作り直す回数も分けておくと、次に何を改善すべきか見えます。
旧TTSからは、原稿の渡し方とWAV保存を点検する
3.8同士の互換性を、旧モデルへの互換性と混同しない
旧Gemini TTSから移す場合、公式移行資料は、文章中に埋め込んでいた継続的な演技指定をspeech_metadataへ移すよう案内しています。3.8同士が同じ形式だからといって、旧モデル向けの長い演出指示をそのまま読ませる構成でよいとは限りません。移行資料。
まず、既存のリクエストを開き、原稿欄の中に「ゆっくり」「ささやくように」といった指示を混ぜていないかを探します。指示の部分と、聞き手に伝えたい文章を分け、変更前後の入力を保存してください。生成後は、演技の指定が発話に混ざっていないかも耳で確かめます。
音声データを二重にWAVへ包まない
もう1つの変更が、単発のAPI応答ではWAVが既定になった点です。以前のTTSモデルは、ヘッダーのないPCM音声を既定で返していました。旧コードでWAVのヘッダーを付けていた場合、3.8からの戻り値に同じ処理を重ねないよう見直します。Flash TTSの移行上の注意。
PCMは音の標本データ、WAVはそれに再生に必要な情報を付けたファイル形式と考えると分かりやすくなります。中身がすでにWAVなのに、従来の処理でさらに包んでしまわないかを確認する、という変更です。生のPCMが必要な構成では、欲しい出力形式を明示します。
点検する場所は、原稿を送る処理と、音声を受け取って保存する処理の両側です。
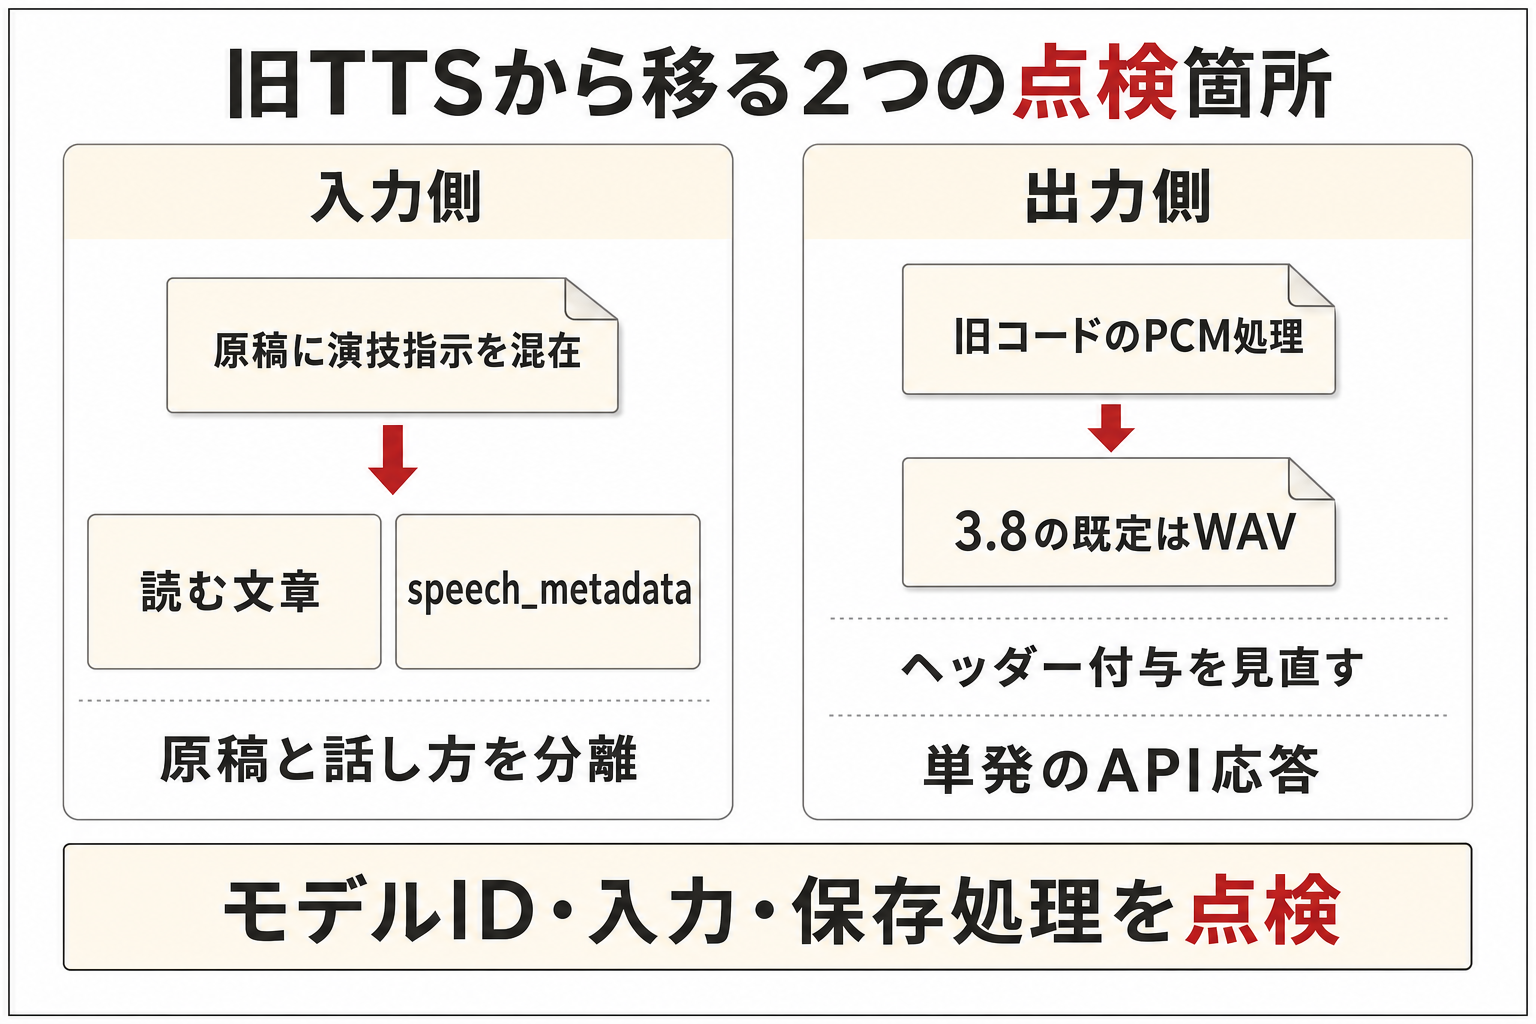
旧Gemini TTSから3.8への移行を入力側と出力側の2パネルで整理。入力は原稿と演技指定を分離し、単発API応答の出力は既定WAVに合わせて旧PCM用のヘッダー付与を見直す。最下部にモデルID・入力・保存処理の点検を示す。
モデルIDの変更に加えて、入力を組み立てる箇所と保存する箇所を確認します。既存コードでは、以前の音声形式を前提とした処理を探してください。
日本語の短い台本で、採用できる声かを確かめる
最初は原稿と声を揃えて試聴する
初回はGoogle AI Studioの音声生成から試す入口が案内されています。公式の開始案内。画面上の細かな操作は配信状況で変わるため、ここではAPI実装に進む前の比較条件を提案します。
想定シナリオ:サービスの使い方を説明する短い動画です。次の文を試聴用の原稿として使い、実際の製品名や手順へ置き換えてください。これは本稿で作った例文で、生成結果ではありません。
画面右上の設定を開き、通知を選んでください。
メール通知をオンにすると、更新のお知らせが届きます。
設定を変えたくない場合は、そのまま画面を閉じてください。
声を選び、読ませたい原稿と話し方の指定を分けて生成します。同じ声・同じ原稿で両モデルを試し、どちらの音声かを伏せて聞く方法もあります。最初から原稿、声、モデルを全部変えると、どの変更が聞きやすさに影響したのか判断しにくくなります。
聞き取りやすさを、具体的な箇所で記録する
比較に使える記録欄を、次のように用意します。点数の合格ラインを一律に決めるより、実際の動画やアプリで直さずに使えるかを見てください。
見る箇所 | 試聴時に残す記録 |
|---|---|
原稿との一致 | 抜けた語、余分に読んだ語、数値や単位の読み |
発音 | 製品名、略語、同音異義語で直したい箇所 |
区切りと速度 | 操作画面に追いつけるか、文の途中で意味が切れないか |
声の変化 | 冒頭と末尾で、声量や印象が気になるほど変わらないか |
作業量 | 生成待ち、再生成、音声編集に要した時間 |
説明動画なら、音声だけでなく画面と合わせて見ることも必要です。聞き心地がよくても、操作を示す場面より早く説明が終われば、動画側の調整が残ります。完成品に組み込んだ状態で確かめると、単独の試聴では見えなかった修正箇所を記録できます。
二者会話と品質の発表には、利用条件を添えて読む
1リクエストでの複数話者生成について、TTS仕様はプリセット音声で最大2人としています。カスタム設計・複製した声を組み合わせる会話では、話者ごとのターンを個別に生成し、音声を連結する方法を案内しています。自作した声を2つ指定するだけで、すべての会話生成が完結するとは受け取らないでください。複数話者の制約。
また、Googleは表現力や評価指標での改善を説明していますが、本稿ではその順位を、個別の日本語原稿での優位へ一般化しません。音声モデルのカードには、誤りに加え、遅延やタイムアウトの可能性も記載されています。モデルカード。
今回の更新で検討できるのは、声を設計し直すことと、用途に合わせて2モデルを使い分けることです。まず短い原稿で、読み間違いと修正量を確認します。採用できる見込みが立ったら長い原稿へ広げ、旧APIの入力と保存処理、継続利用時の単価を点検してください。声が作れた段階と、用途に合う音声が完成した段階を分けて判断すると、次に試す条件を絞れます。
参考・出典
- Google「Gemini 3.8 text-to-speech says hello」(2026-09-23、参照日: 2026-09-25)https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
- Google AI for Developers「Release notes」September 22, 2026(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/changelog
- Google AI for Developers「Gemini 3.8 Flash TTS」(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-tts
- Google AI for Developers「Gemini 3.8 Flash-Lite TTS」(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-lite-tts
- Google AI for Developers「Text-to-speech generation (TTS)」(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/speech-generation
- Google AI for Developers「Voice design」(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/voice-design
- Google AI for Developers「Voice replication」(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/voice-replication
- Google AI for Developers「Gemini Developer API pricing」Standard料金(参照日: 2026-09-25)https://ai.google.dev/gemini-api/docs/pricing
- Google DeepMind「Gemini 3.8 Audio — Model Card」(参照日: 2026-09-25)https://deepmind.google/models/model-cards/gemini-3-8-audio/